Обучение как поиск
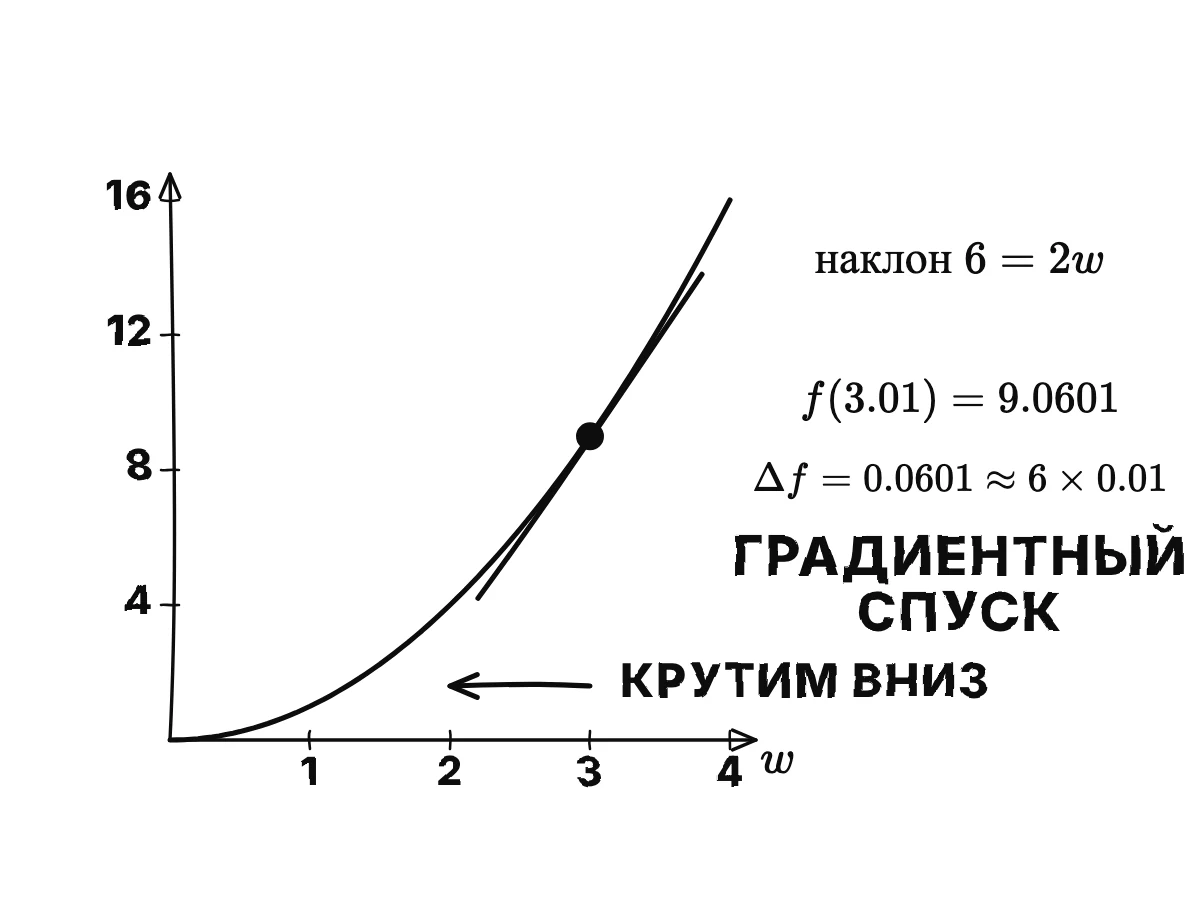
Наклон w в квадрате при тройке
Вот эта идея на одной ручке и на числах, которые можно проверить. Пусть ошибка модели равна f(w) = w², а ручка стоит на w = 3, так что ошибка равна девяти.
Alice's Adventures in a Differentiable Wonderland, Volume I: A Tour of the Land
Один и тот же текст на каждом уровне, на всех языках и во всех оформлениях, что здесь есть. Выберите, потом слушайте или скачивайте.
Тот же плеер, который продукт даёт для вашей книги: голос, рисунки по мере того, как они рисуются, текст.
Современный учебник о том, как на самом деле устроены нейросети: от тензоров и градиентов до трансформеров. Первые три главы закладывают основу: о чём книга, линейная алгебра и анализ, на которых работает сеть, градиентный спуск, что такое набор данных и функция потерь.
Это пробная часть: 3 из 13 (главы).
Вот эта идея на одной ручке и на числах, которые можно проверить. Пусть ошибка модели равна f(w) = w², а ручка стоит на w = 3, так что ошибка равна девяти.
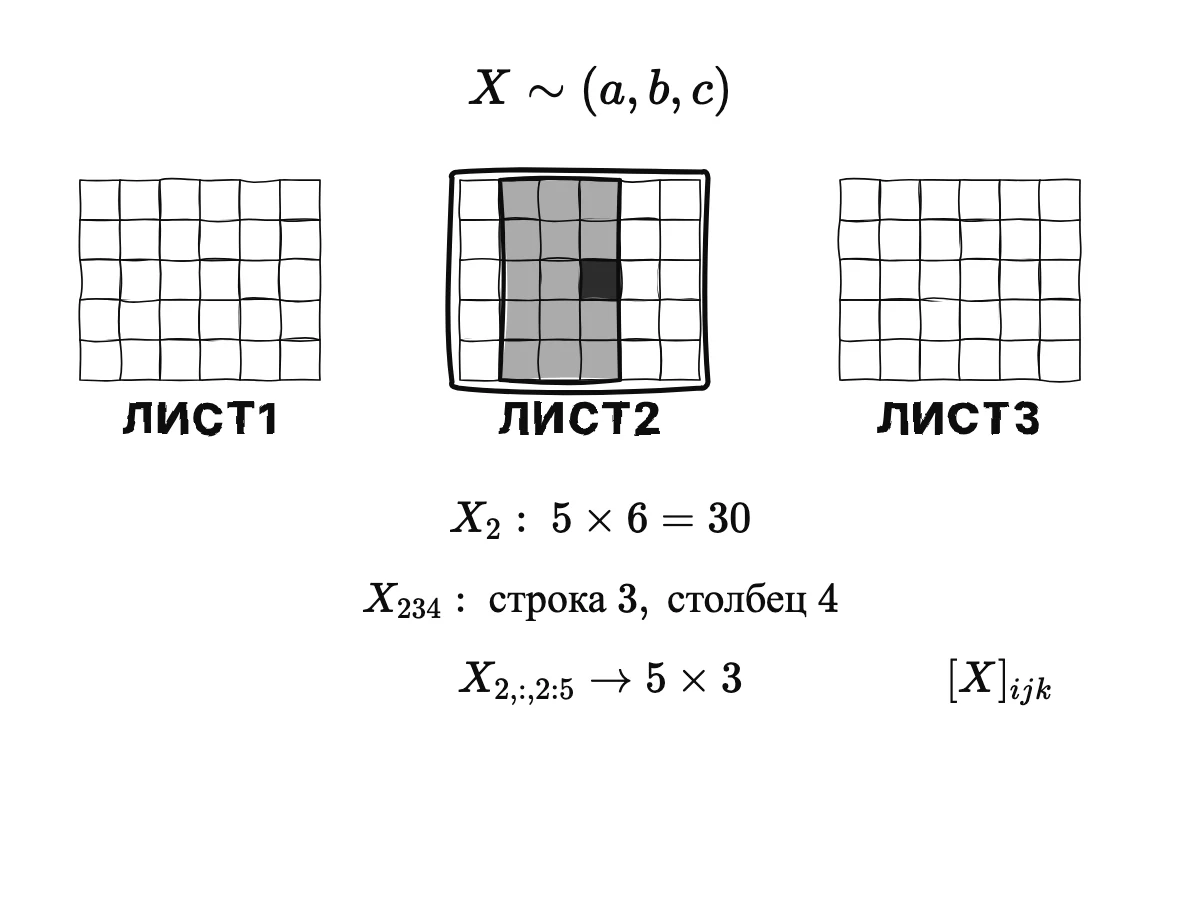
Возьмём трёхмерный тензор X ∼ (a, b, c). Тогда Xᵢ — один срез формы (b, c): в нашем батче фотографий X₂ — вся вторая фотография, сетка 5 на 6 из 30 чисел. А Xᵢⱼₖ — один скаляр: X₂₃₄ — яркость пикселя в строке 3, столбце 4 второй фотографии, одна крошка батона.
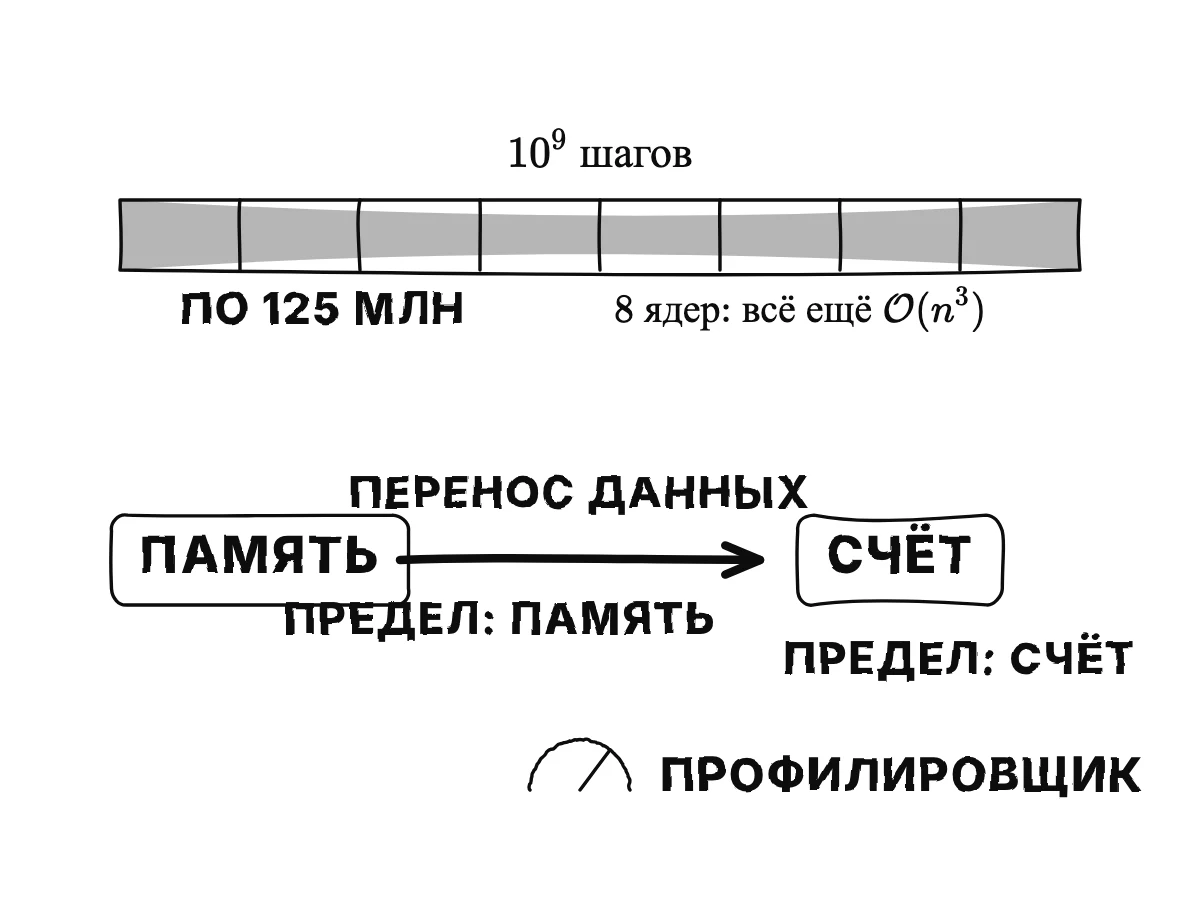
Ещё два предела асимптотического мышления. Первый: наличие k процессоров совсем не меняет «О большое»: в лучшем случае оно делит время на k, постоянный множитель; восемь ядер превращают миллиард шагов в 125 миллионов на каждое, по-прежнему кубически по n.
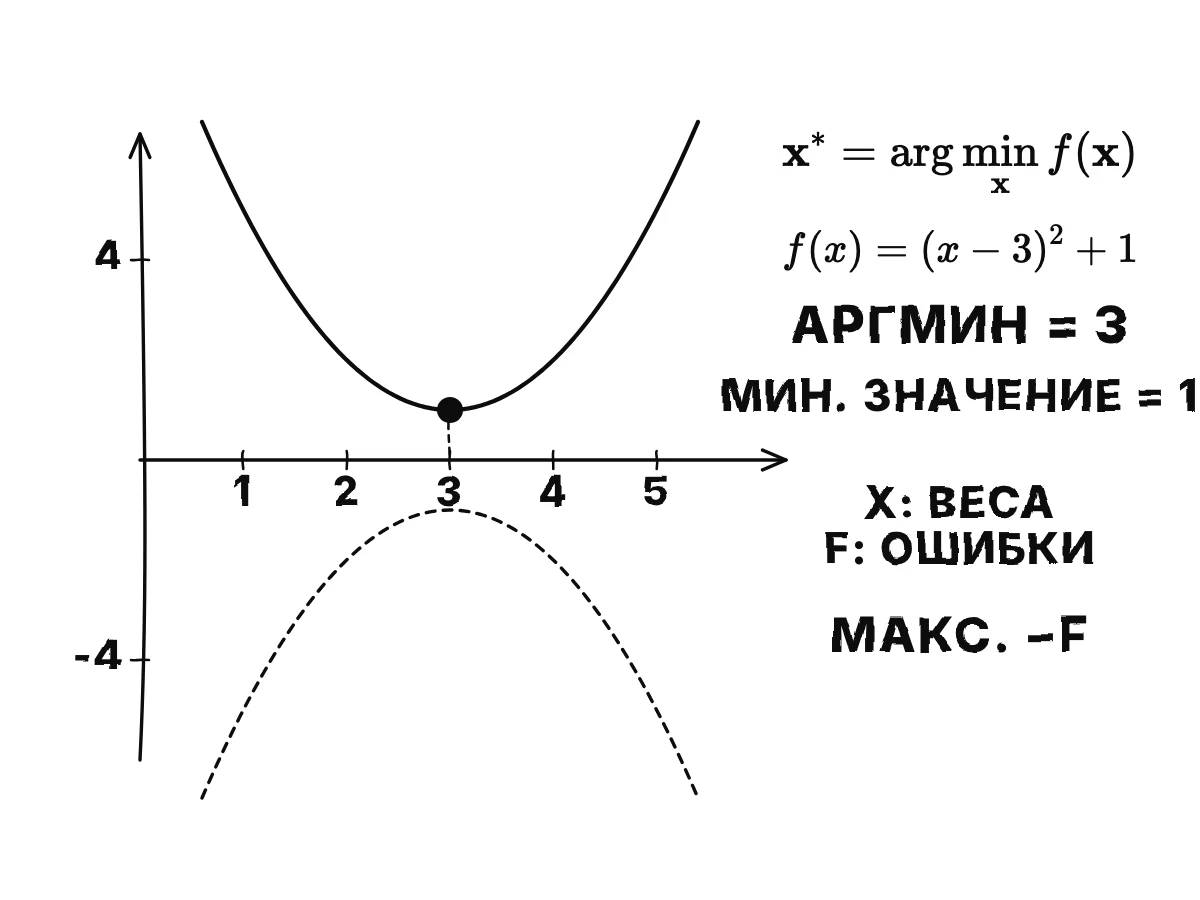
Теперь причина, по которой градиенты стоят всех этих хлопот: раздел 2.3, градиентный спуск. Задача — минимизировать функцию f(𝐱) при 𝐱 ∼ (d): 𝐱* = argmin f(𝐱). Как и аргмакс, аргмин означает «то значение x, которое даёт наименьшее возможное f».
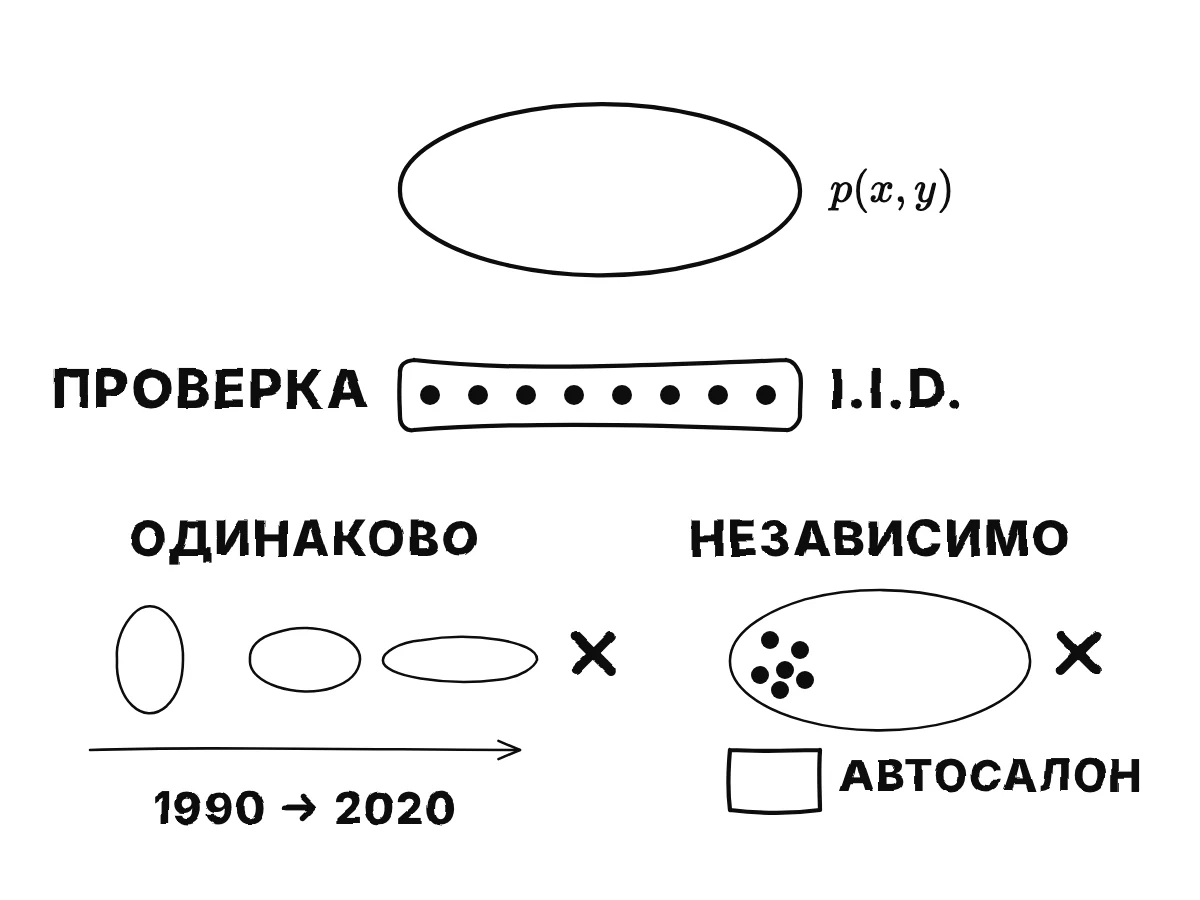
Добавляется ещё одно предположение, и оно решающее: каждый пример — независимая и одинаково распределённая выборка, i.i.d., из некоторого неизвестного и, по сути, непознаваемого распределения вероятностей p(x, y). Звучит технически, но именно это придаёт задаче смысл.
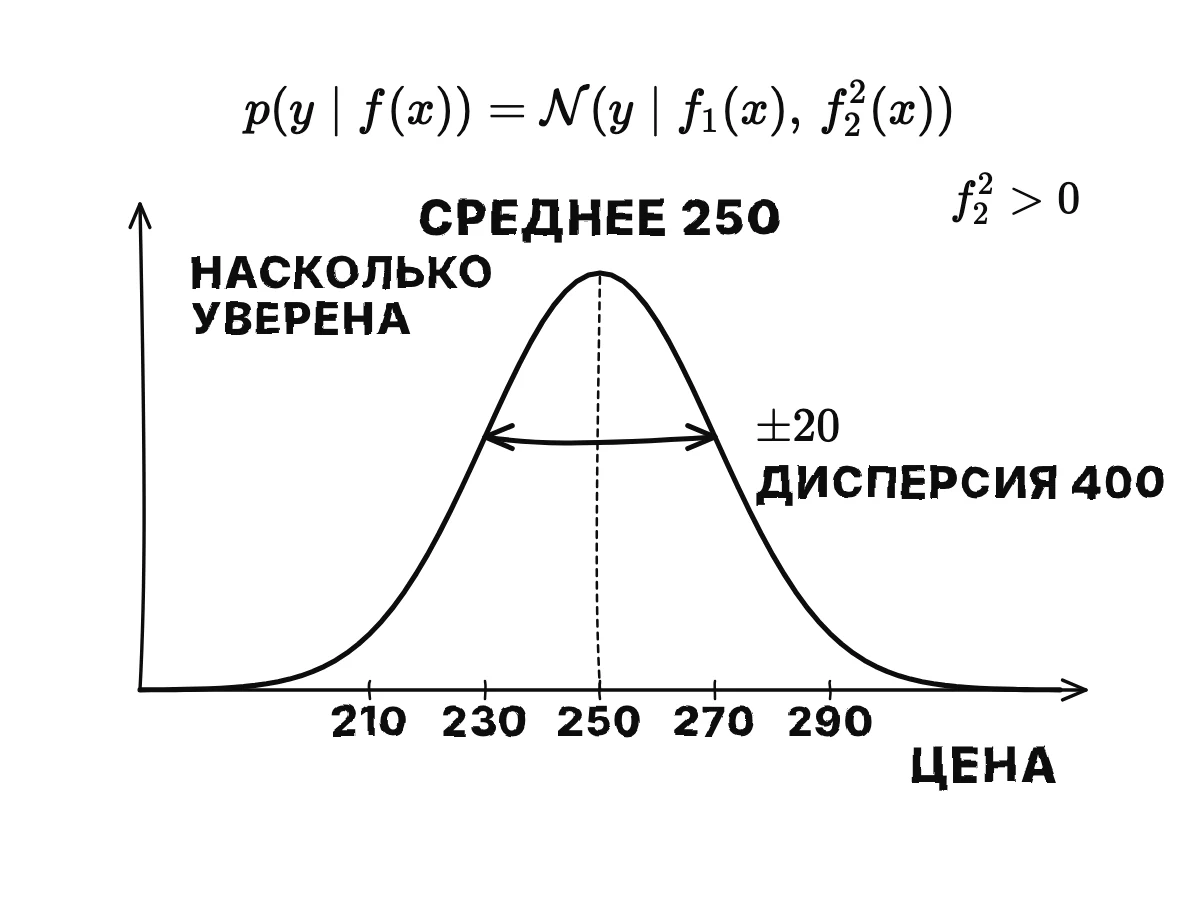
Для регрессии, предсказания вещественного числа y ∈ ℝ, модель может выдавать два значения, f(x) ∼ (2), среднее и разброс гауссианы, колоколообразной кривой: p(y ∣ f(x)) = 𝒩(y ∣ f₁(x), f₂²(x)). Второй выход возводится в квадрат, чтобы дисперсия всегда была положительной.
Примеры для: a curious adult with school maths who uses AI apps every day; add one modern instance per idea, such as how a chat assistant or a phone's photo app is trained
Лекции пересказывают с английского оригинала книгу arXiv 2404.17625 (version 3, 2025), автор — Симоне Скардапане; книга вышла под открытой лицензией, которая разрешает пересказ и перевод. Пересказ, рисунки и голос сделаны ИИ и сверены с книгой второй моделью. Как используется ИИ.
Лекции — переработка оригинала и распространяются под той же лицензией: их можно свободно распространять и перерабатывать с указанием автора и ссылкой на эту страницу: CC BY-SA 4.0
Загрузите учебник или любую сложную книгу. Первые пять минут бесплатно.
Загрузить книгу