Aprender es buscar
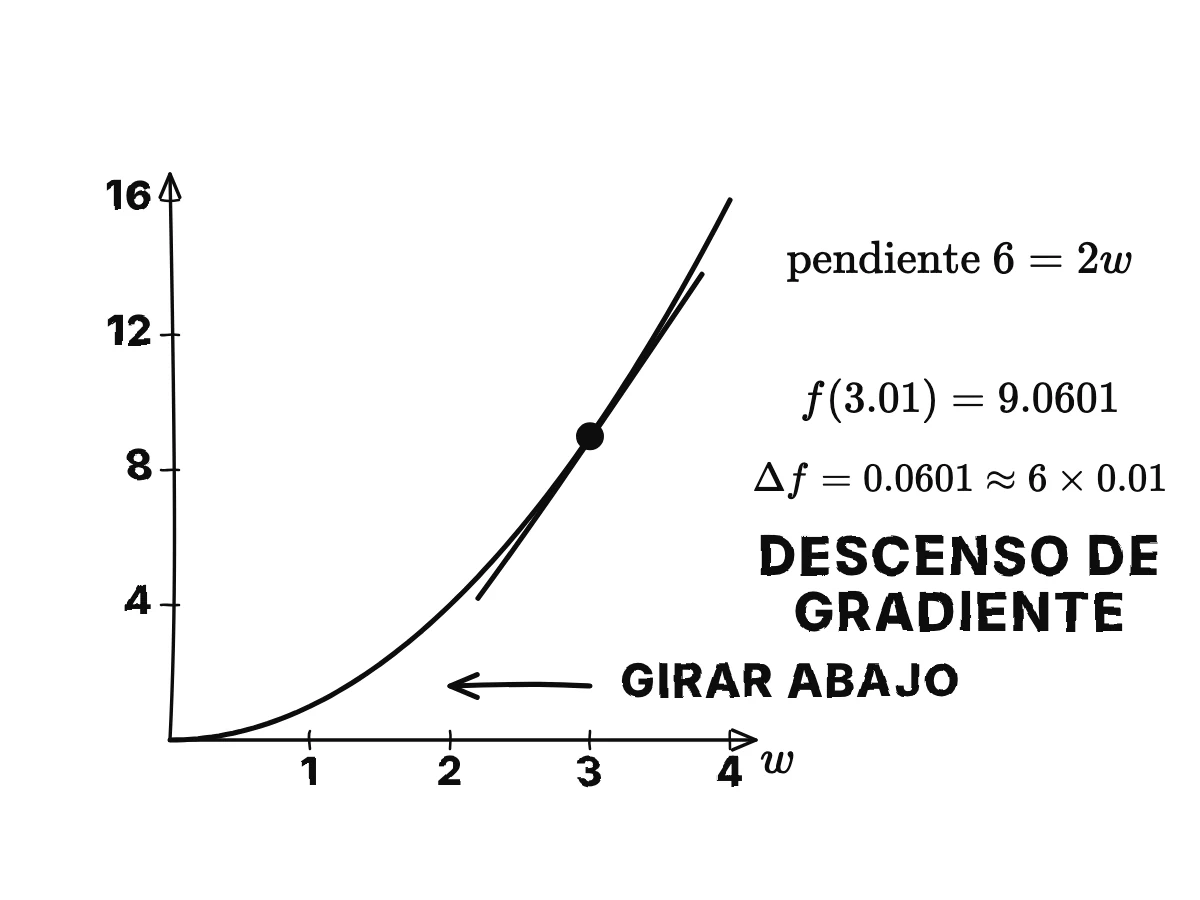
Pendiente de w al cuadrado en tres
Aquí está la idea con una sola rueda y números que podemos comprobar. Suponga que el error de un modelo es f(w) = w², y la rueda está en w = 3, así que el error es nueve.
Alice's Adventures in a Differentiable Wonderland, Volume I: A Tour of the Land
Один и тот же текст на каждом уровне, на всех языках и во всех оформлениях, что здесь есть. Выберите, потом слушайте или скачивайте.
Тот же плеер, который продукт даёт для вашей книги: голос, рисунки по мере того, как они рисуются, текст.
Современный учебник о том, как на самом деле устроены нейросети: от тензоров и градиентов до трансформеров. Первые три главы закладывают основу: о чём книга, линейная алгебра и анализ, на которых работает сеть, градиентный спуск, что такое набор данных и функция потерь.
Это пробная часть: 3 из 13 (главы).
Aquí está la idea con una sola rueda y números que podemos comprobar. Suponga que el error de un modelo es f(w) = w², y la rueda está en w = 3, así que el error es nueve.
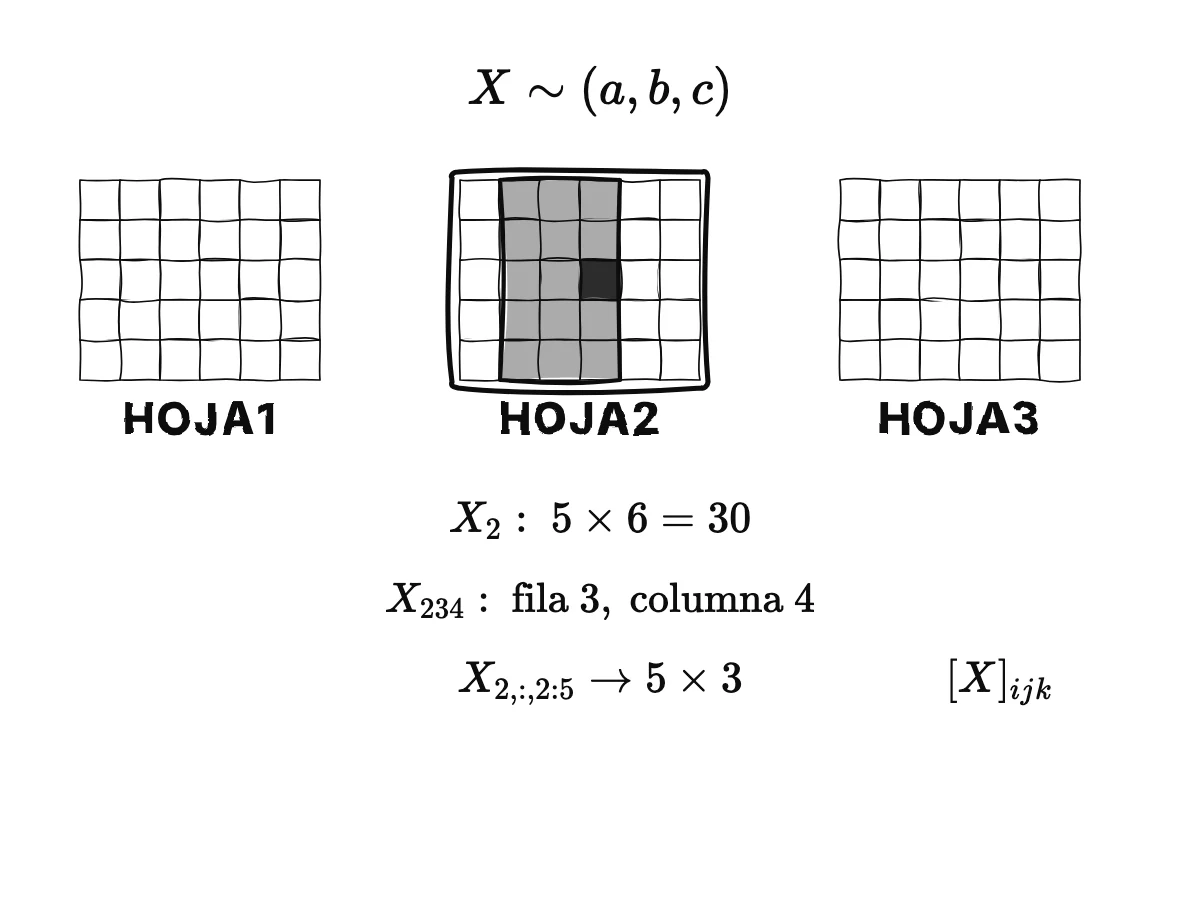
Tome un tensor tridimensional X ∼ (a, b, c). Entonces Xᵢ es una rebanada de forma (b, c): en nuestro lote de fotos, X₂ es la segunda foto entera, una rejilla de 5 por 6 con 30 números.
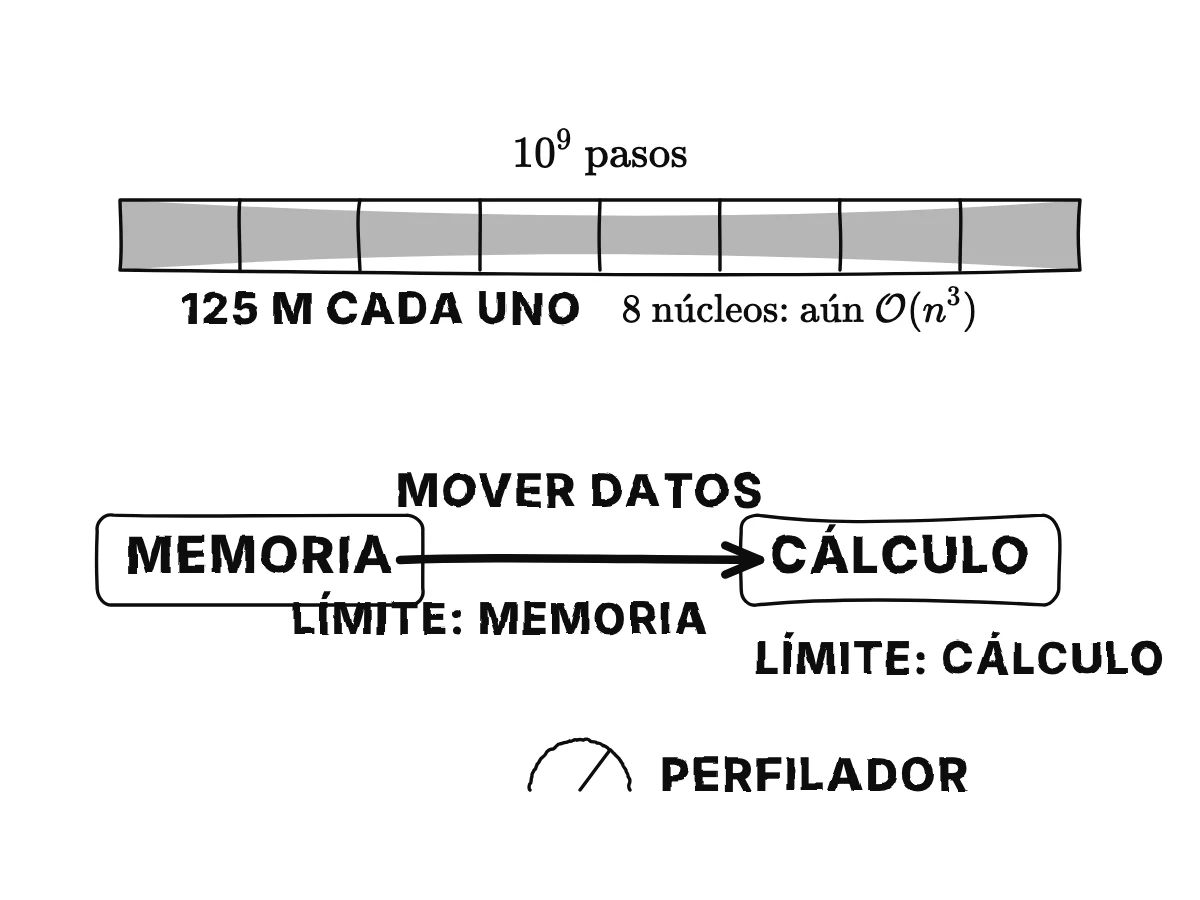
Dos límites más del pensamiento asintótico. Primero, tener k procesadores no cambia en absoluto la O grande: como mucho divide el tiempo por k, un factor constante; ocho núcleos convierten mil millones de pasos en 125 millones cada uno, todavía cúbico en n.
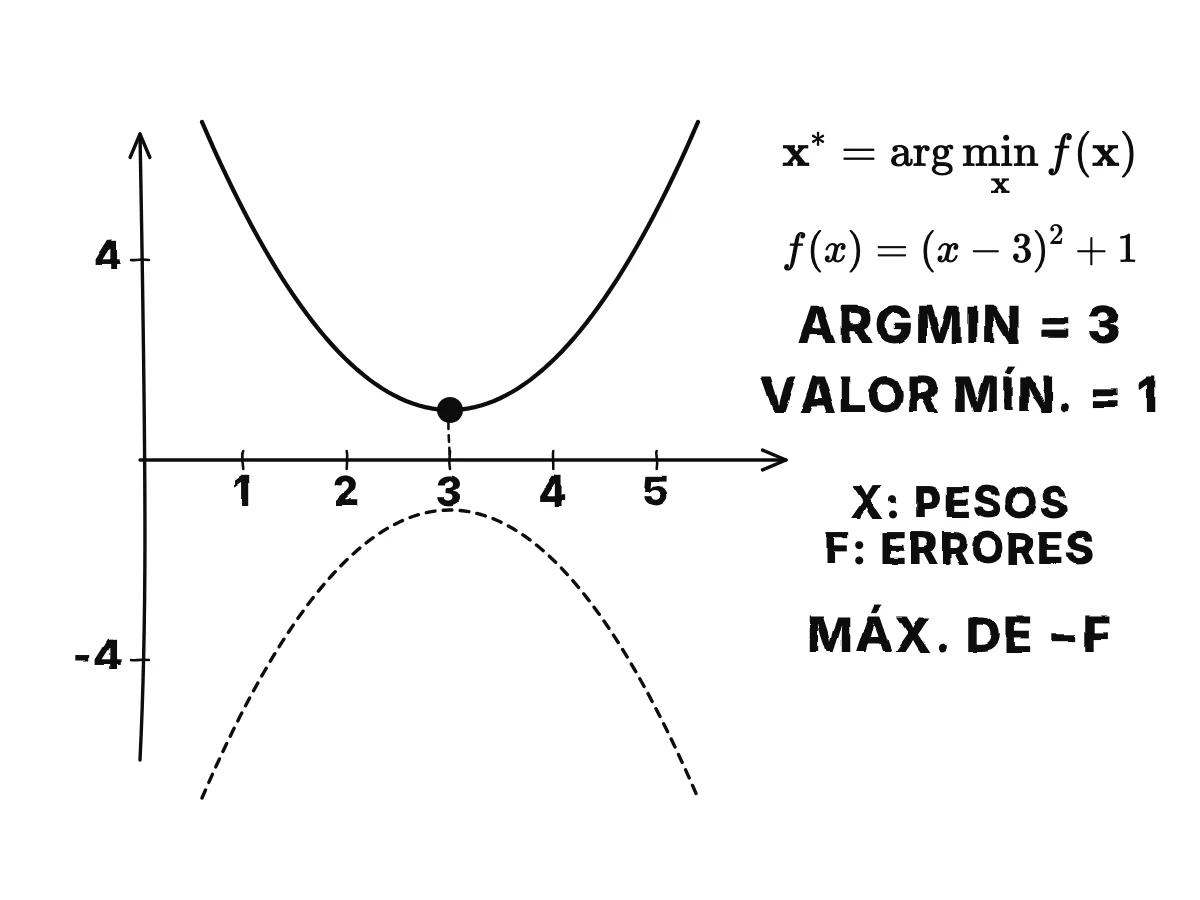
Ahora la razón por la que los gradientes merecen todo esto: la sección 2.3, el descenso de gradiente. La tarea es minimizar una función f(𝐱) con 𝐱 ∼ (d): 𝐱* = argmin f(𝐱). Como argmax, argmin significa «el valor de x que da la f más baja posible».
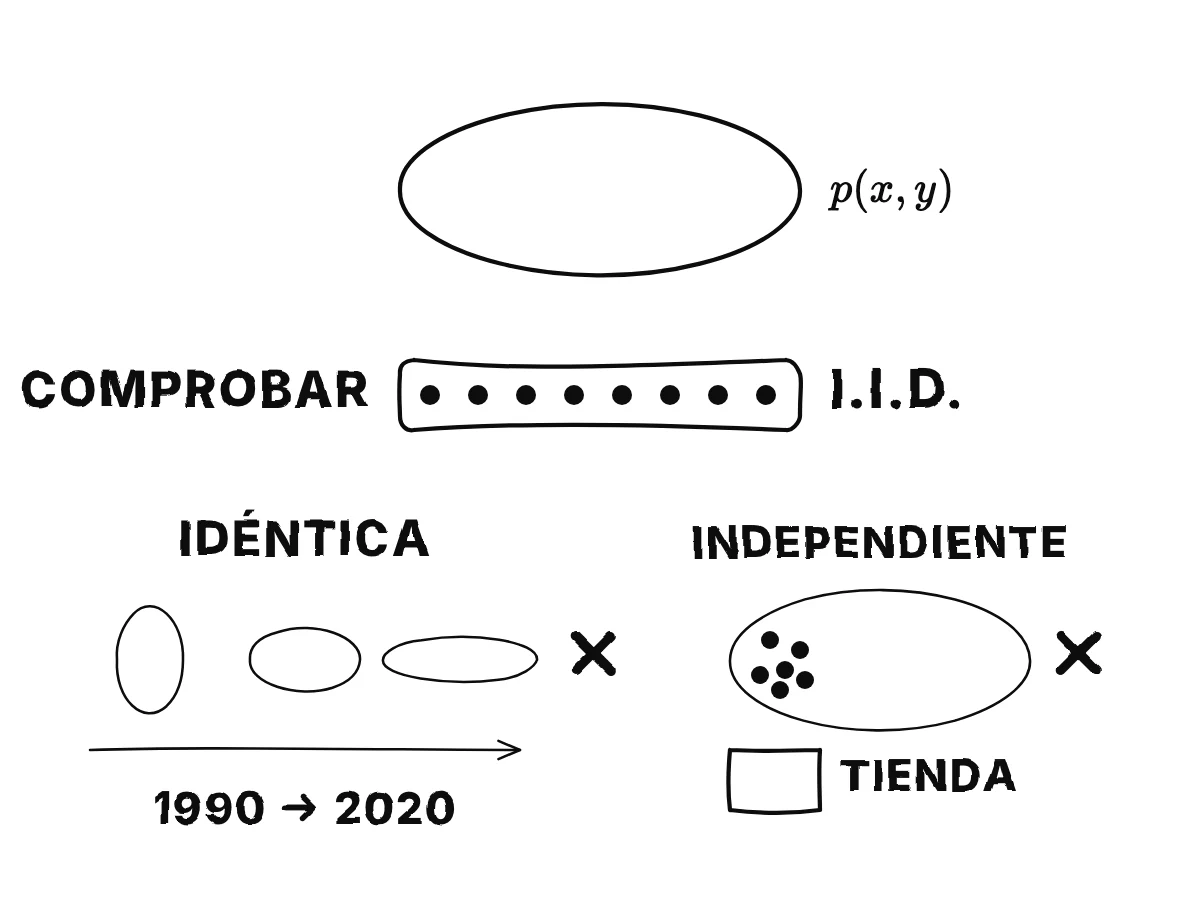
Se añade un supuesto más, y es crucial: cada ejemplo es una extracción independiente e idénticamente distribuida, i.i.d., de alguna distribución de probabilidad p(x, y) desconocida, y de hecho incognoscible. Suena técnico, pero es lo que da sentido a la tarea.
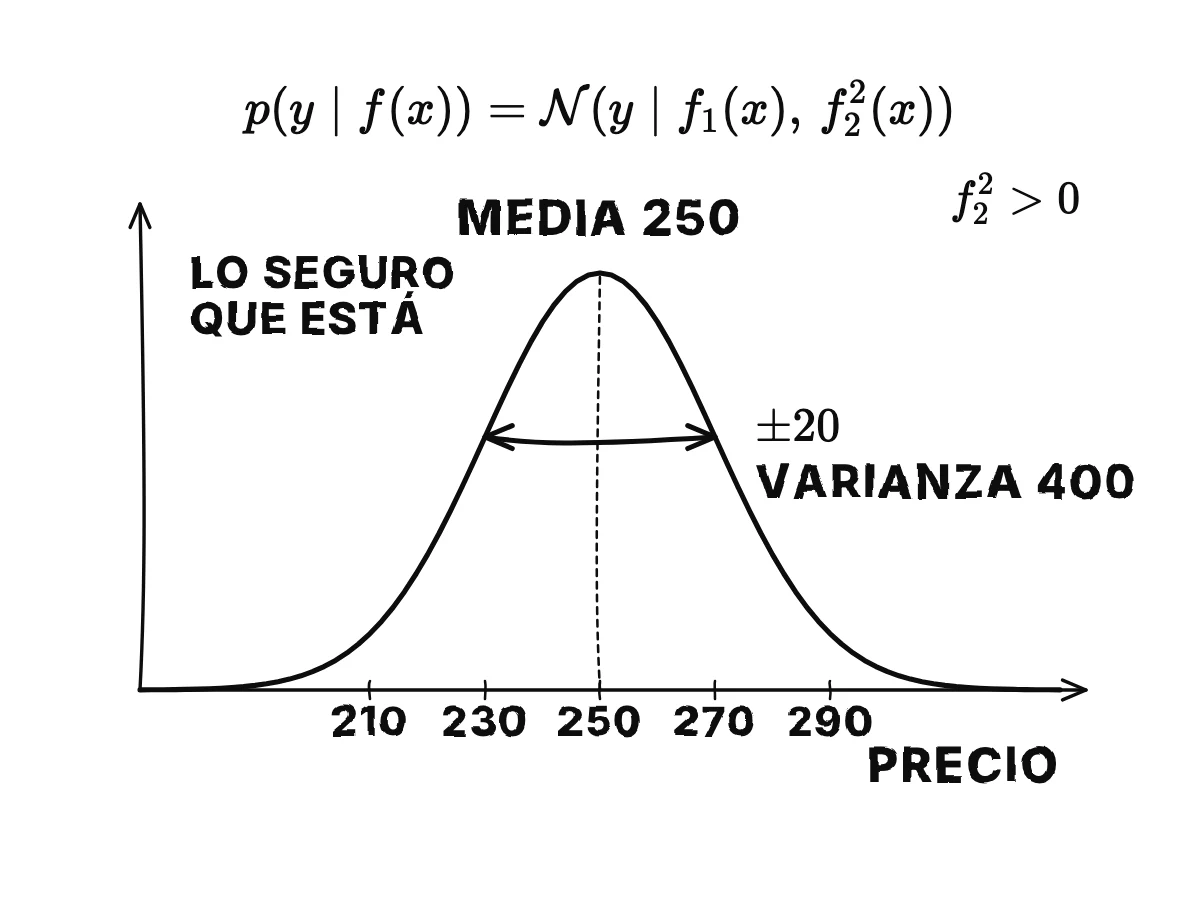
Para la regresión, predecir un número real y ∈ ℝ, el modelo puede producir dos valores, f(x) ∼ (2), la media y la dispersión de una gaussiana, una curva de campana: p(y ∣ f(x)) = 𝒩(y ∣ f₁(x), f₂²(x)). La segunda salida se eleva al cuadrado para que la varianza sea siempre positiva.
Примеры для: a curious adult with school maths who uses AI apps every day; add one modern instance per idea, such as how a chat assistant or a phone's photo app is trained
Лекции пересказывают с английского оригинала книгу arXiv 2404.17625 (version 3, 2025), автор — Симоне Скардапане; книга вышла под открытой лицензией, которая разрешает пересказ и перевод. Пересказ, рисунки и голос сделаны ИИ и сверены с книгой второй моделью. Как используется ИИ.
Лекции — переработка оригинала и распространяются под той же лицензией: их можно свободно распространять и перерабатывать с указанием автора и ссылкой на эту страницу: CC BY-SA 4.0
Загрузите учебник или любую сложную книгу. Первые пять минут бесплатно.
Загрузить книгу