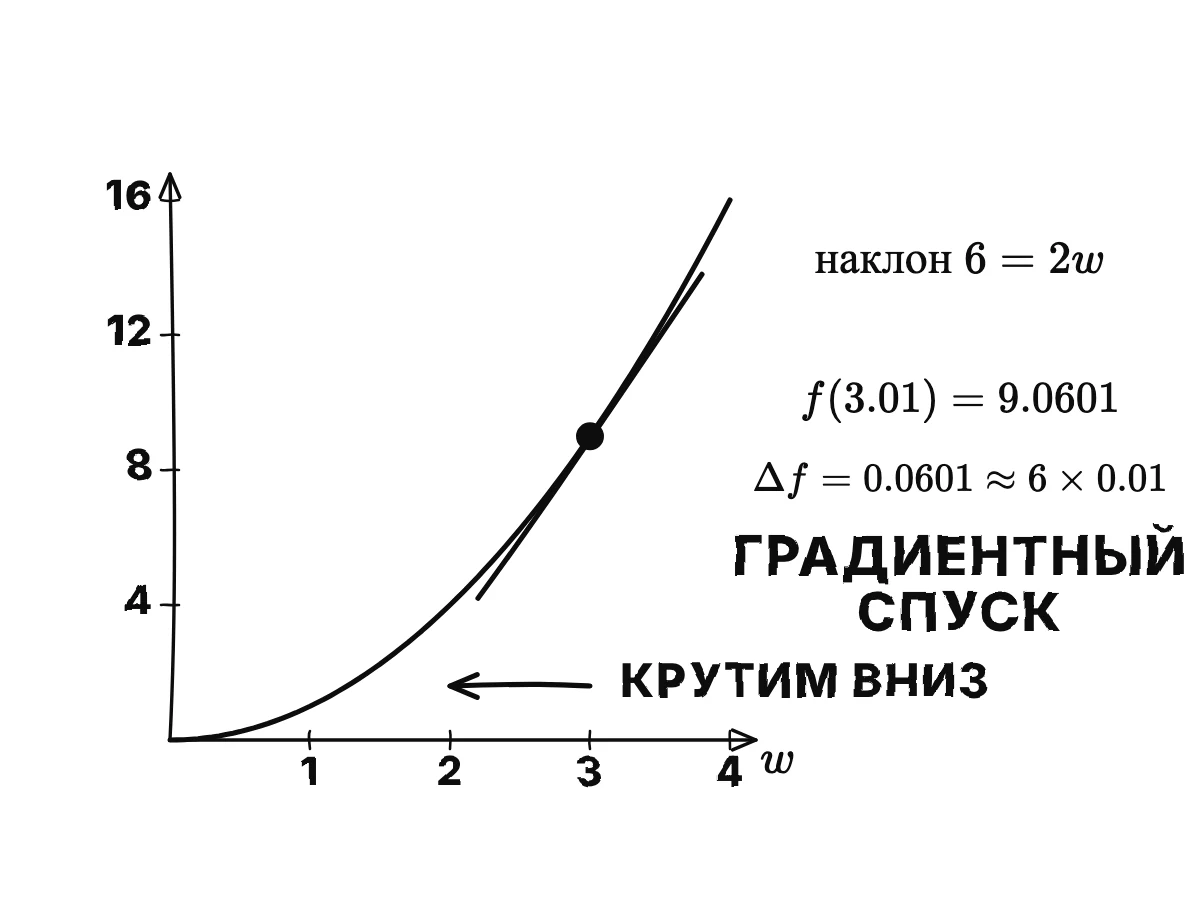
Обучение как поиск
Наклон w в квадрате при тройке
Вот эта идея на одной ручке и на числах, которые можно проверить. Пусть ошибка модели равна f(w) = w², а ручка стоит на w = 3, так что ошибка равна девяти.
Alice's Adventures in a Differentiable Wonderland, Volume I: A Tour of the Land
The same text, told at every level, in every language and look shown here. Pick, then listen or download.
The same player the product gives for your own book: the voice, the drawings as they are drawn, the text.
A modern textbook on how neural networks really work, from tensors and gradients to transformers. The first three chapters lay the ground: what the book is about, the linear algebra and calculus a network runs on, gradient descent, and what a dataset and a loss function are.
This is a sample: 3 of 13 chapters.
Вот эта идея на одной ручке и на числах, которые можно проверить. Пусть ошибка модели равна f(w) = w², а ручка стоит на w = 3, так что ошибка равна девяти.
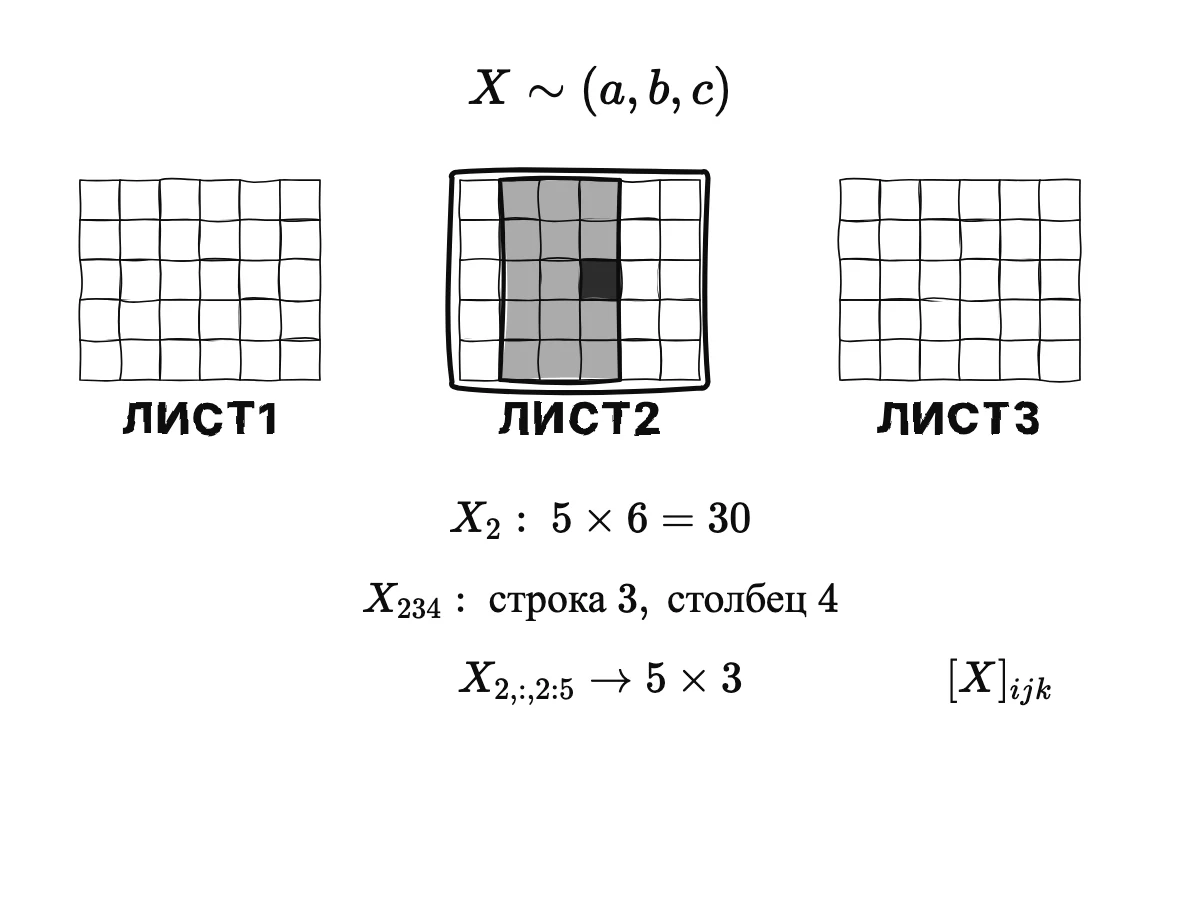
Возьмём трёхмерный тензор X ∼ (a, b, c). Тогда Xᵢ — один срез формы (b, c): в нашем батче фотографий X₂ — вся вторая фотография, сетка 5 на 6 из 30 чисел. А Xᵢⱼₖ — один скаляр: X₂₃₄ — яркость пикселя в строке 3, столбце 4 второй фотографии, одна крошка батона.
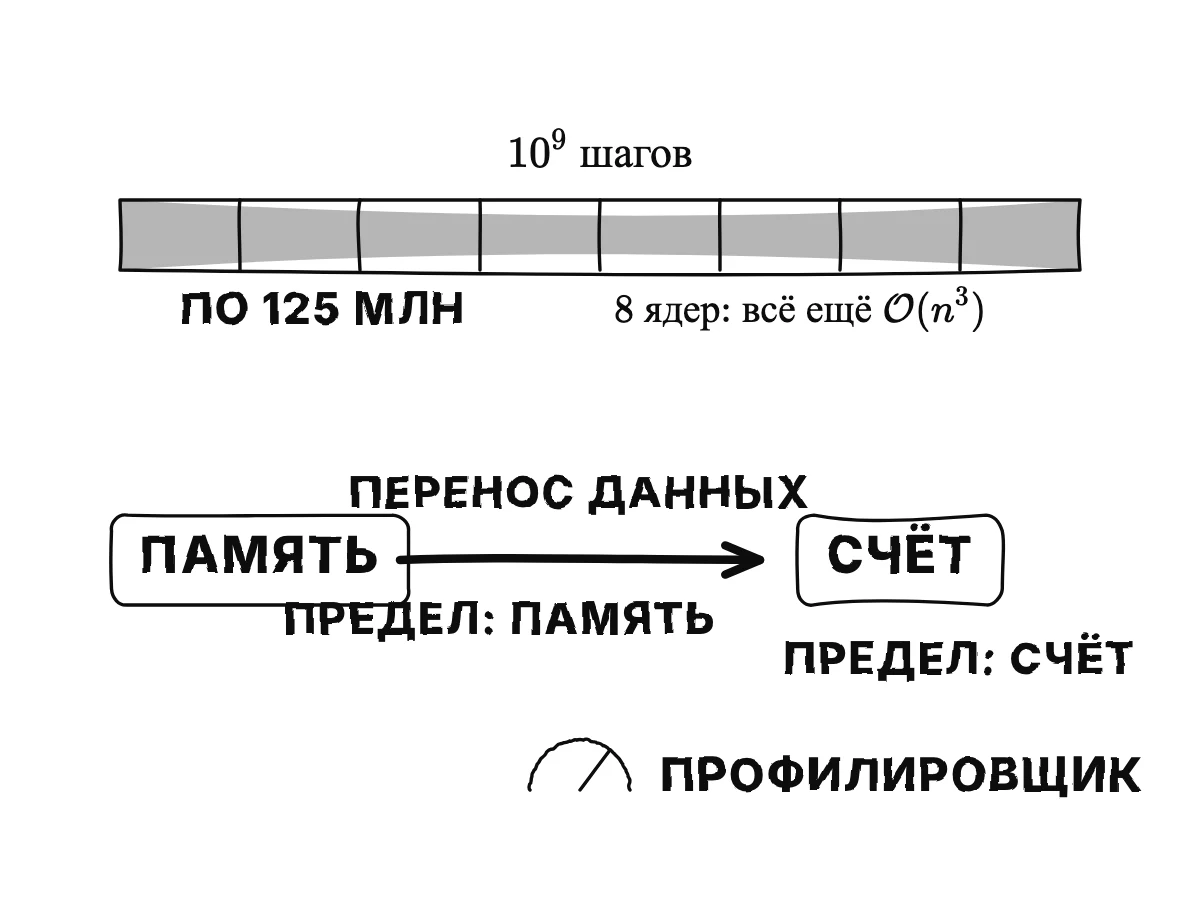
Ещё два предела асимптотического мышления. Первый: наличие k процессоров совсем не меняет «О большое»: в лучшем случае оно делит время на k, постоянный множитель; восемь ядер превращают миллиард шагов в 125 миллионов на каждое, по-прежнему кубически по n.
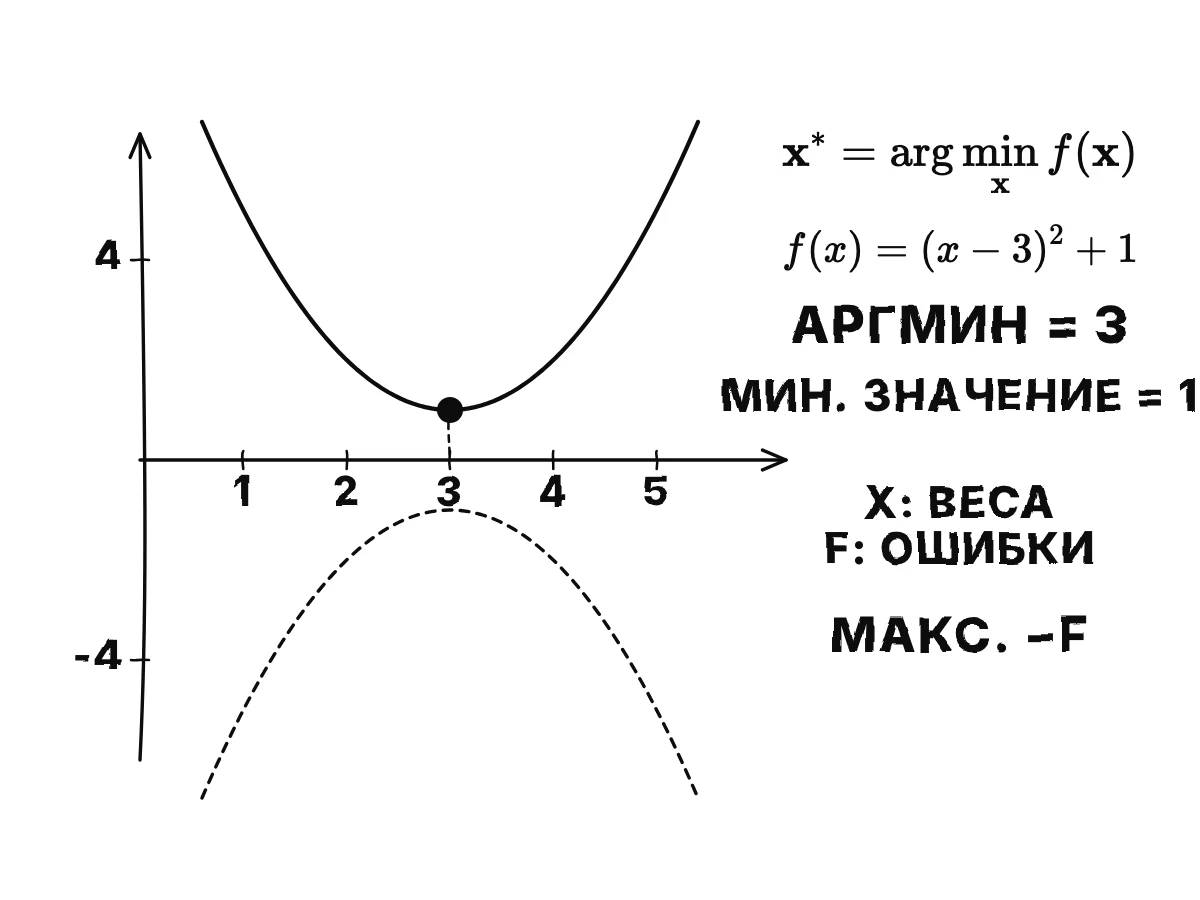
Теперь причина, по которой градиенты стоят всех этих хлопот: раздел 2.3, градиентный спуск. Задача — минимизировать функцию f(𝐱) при 𝐱 ∼ (d): 𝐱* = argmin f(𝐱). Как и аргмакс, аргмин означает «то значение x, которое даёт наименьшее возможное f».
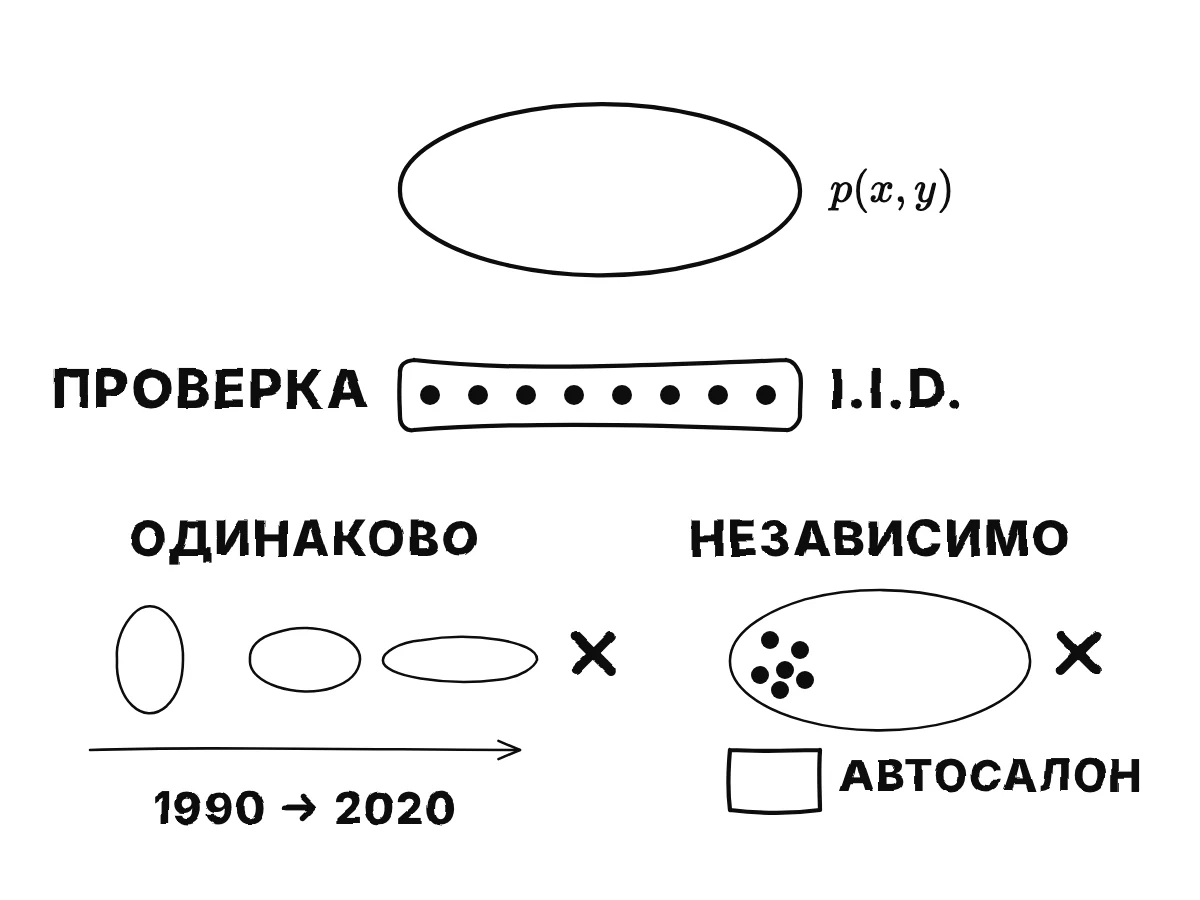
Добавляется ещё одно предположение, и оно решающее: каждый пример — независимая и одинаково распределённая выборка, i.i.d., из некоторого неизвестного и, по сути, непознаваемого распределения вероятностей p(x, y). Звучит технически, но именно это придаёт задаче смысл.
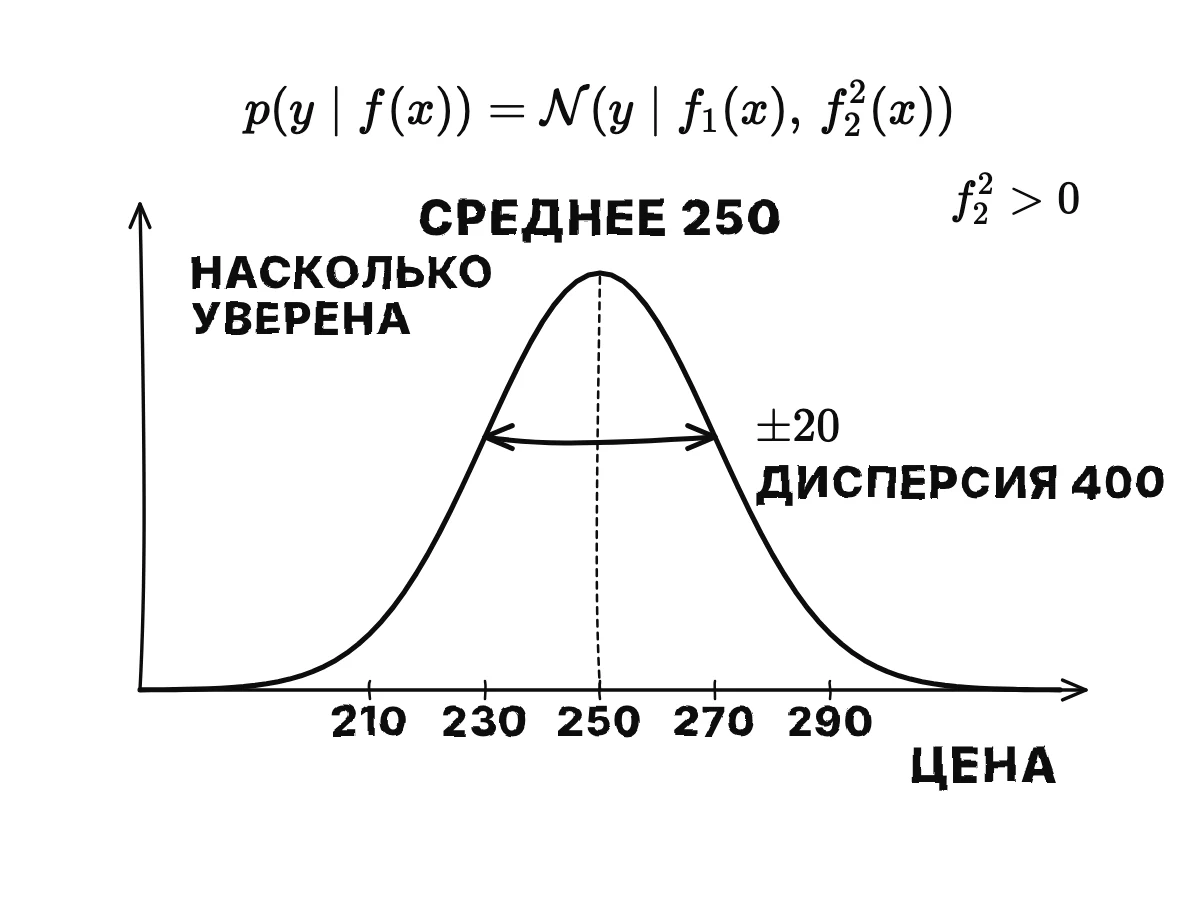
Для регрессии, предсказания вещественного числа y ∈ ℝ, модель может выдавать два значения, f(x) ∼ (2), среднее и разброс гауссианы, колоколообразной кривой: p(y ∣ f(x)) = 𝒩(y ∣ f₁(x), f₂²(x)). Второй выход возводится в квадрат, чтобы дисперсия всегда была положительной.
Examples for: a curious adult with school maths who uses AI apps every day; add one modern instance per idea, such as how a chat assistant or a phone's photo app is trained
The lectures retell the English text of arXiv 2404.17625 (version 3, 2025) by Simone Scardapane, published under an open licence that allows retelling and translation. The retelling, the drawings and the voice are made by AI and checked against the book by a second model. How AI is used.
The lectures adapt the original and are released under the same licence, free to share and adapt with credit to the author and a link to this page: CC BY-SA 4.0
Upload a textbook or any difficult book. The first five minutes are free.
Upload a book