Library · CC BY-SA 4.0

Alice's Adventures in aDifferentiable Wonderland

Alice's Adventures in a Differentiable Wonderland, Volume I: A Tour of the Land

Cover illustration of the book

Choose your version

The same text, told at every level, in every language and look shown here. Pick, then listen or download.

Listen and watch

The same player the product gives for your own book: the voice, the drawings as they are drawn, the text.

A modern textbook on how neural networks really work, from tensors and gradients to transformers. The first three chapters lay the ground: what the book is about, the linear algebra and calculus a network runs on, gradient descent, and what a dataset and a loss function are.

This is a sample: 3 of 13 chapters.

From the lectures

Tres bloques para las partes del libro con sus capítulos, seguidos de un sitio web y cuadernos de laboratorio.
Sobre este libro

Las tres partes del libro

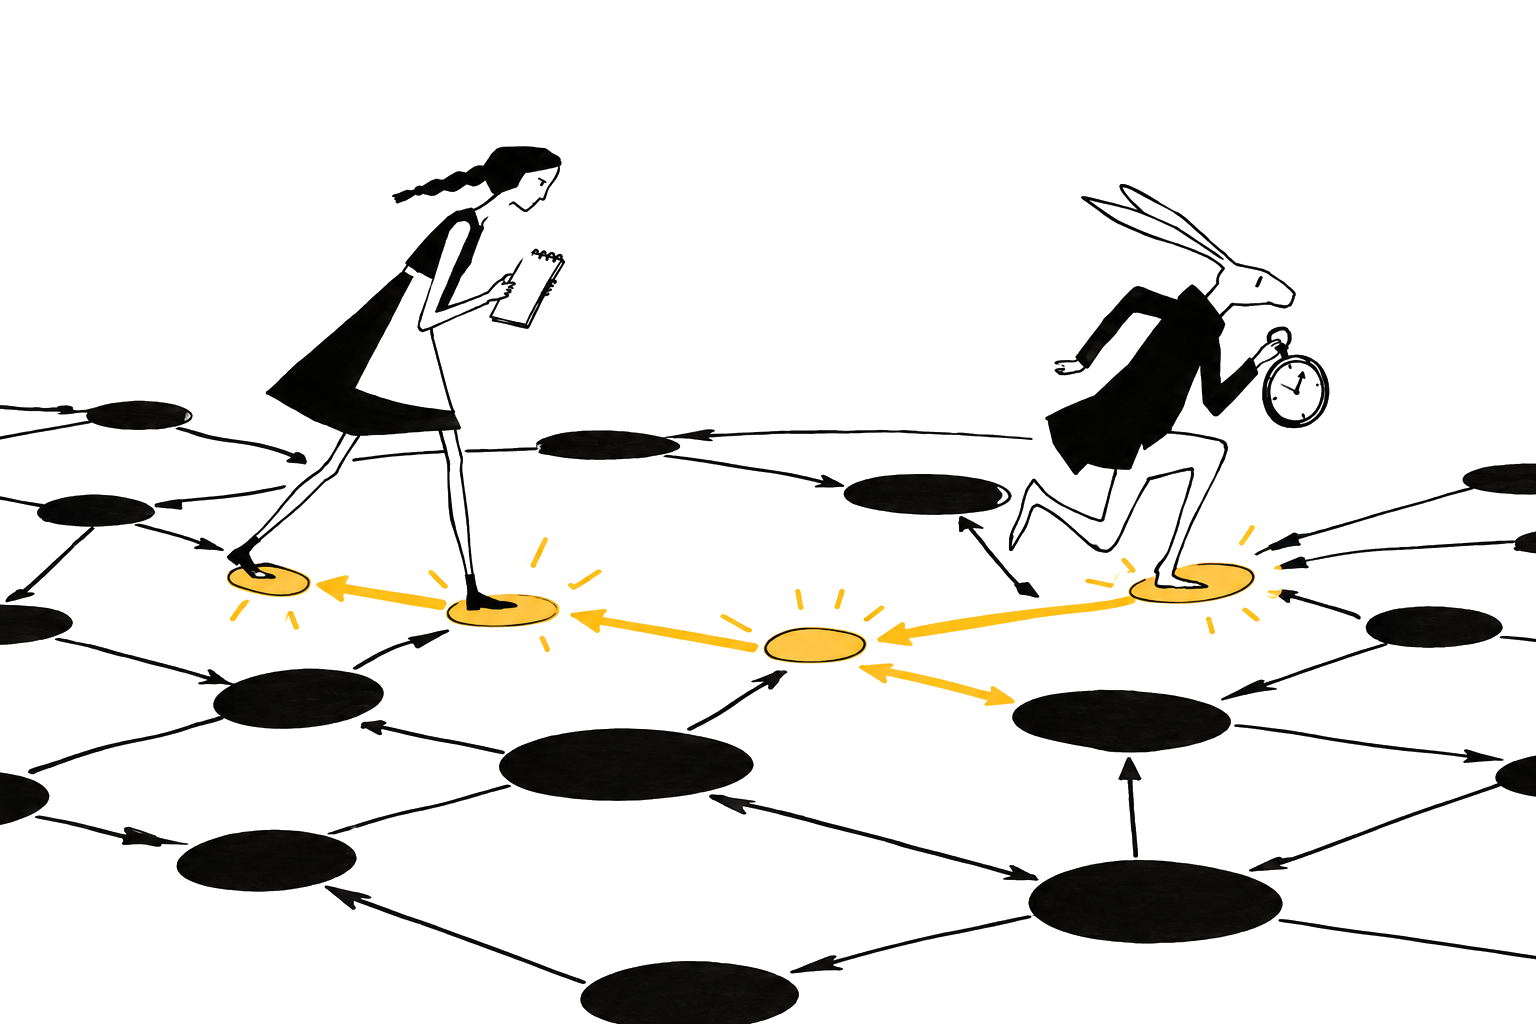
La tercera parte del libro, Por la madriguera del conejo, continúa nuestra exploración de los modelos diferenciables considerando diseños alternativos para conjuntos, sobre todo las capas de atención y los modelos transformadores en los capítulos 10 y 11, los grafos en el capítulo 12 y, por último, las capas recurrentes para secuencias temporales en el capítulo 13.
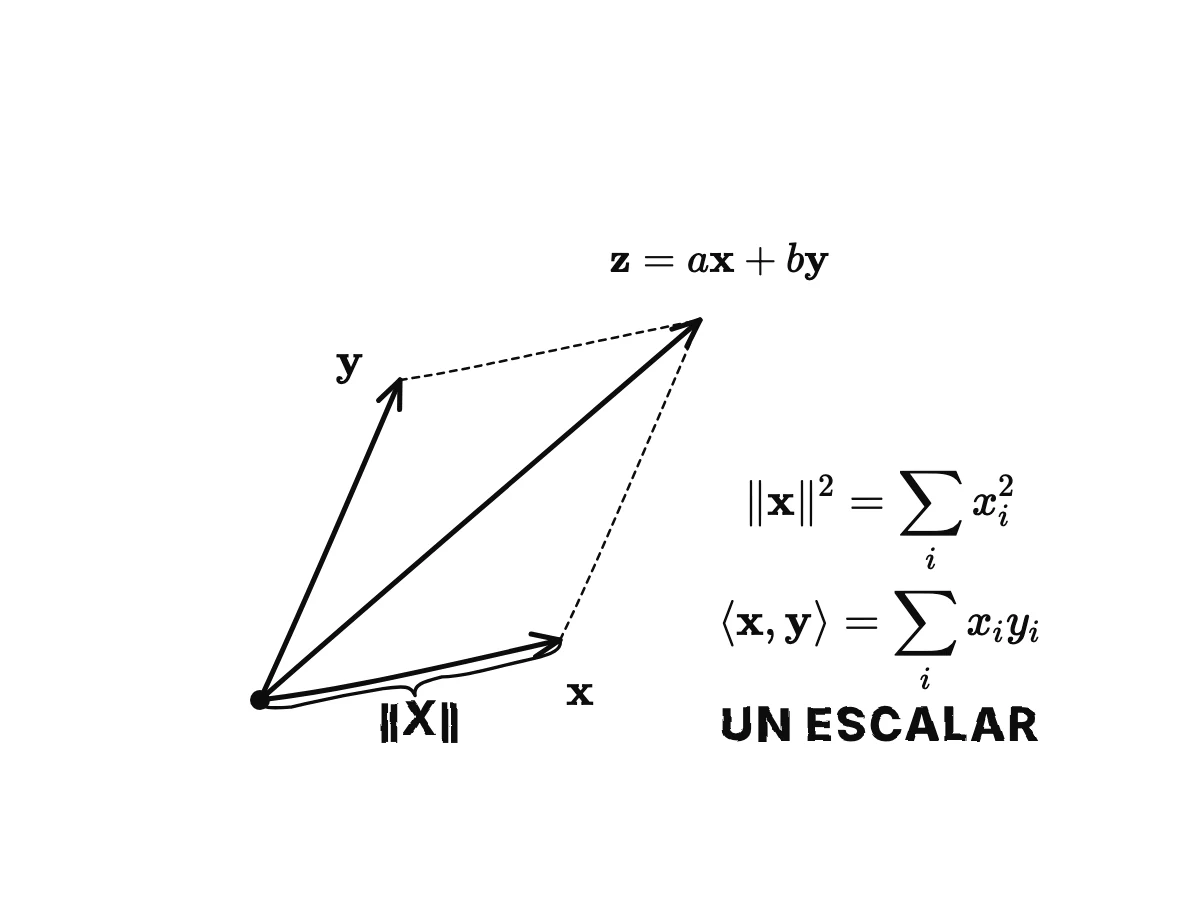
Dos flechas desde el origen y su suma como la diagonal de un paralelogramo; la longitud de una flecha es su norma.
Licencia y preliminares matemáticos

Sumar vectores, medir longitud

Los vectores poseen su propia álgebra, que llamamos espacio vectorial, en el sentido de que dos vectores cualesquiera 𝐱 e 𝐲 de la misma forma pueden combinarse linealmente, 𝐳 = a𝐱 + b𝐲, para dar un tercer vector, con zᵢ = axᵢ + byᵢ.

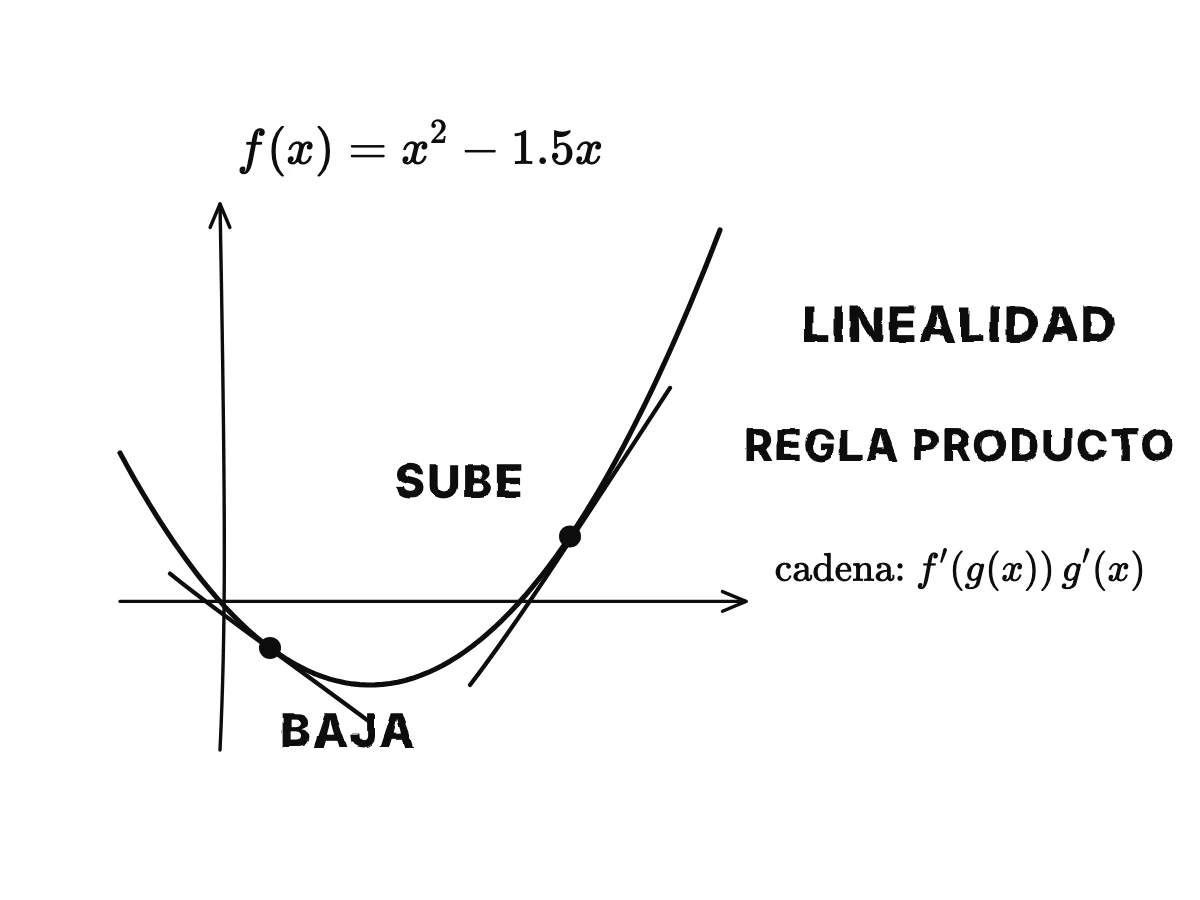
La parábola f(x) = x² − 1.5x con dos rectas tangentes, una que baja donde la pendiente es negativa y otra que sube donde es positiva; luego las tres reglas de las derivadas enumeradas.
La notación de Einstein y las derivadas

Pendientes de x² − 1.5x

Geométricamente, la derivada puede entenderse como la pendiente de la tangente que pasa por un punto, o equivalentemente como la mejor aproximación de primer orden de la propia función en ese punto, como muestra la figura F.2.1.

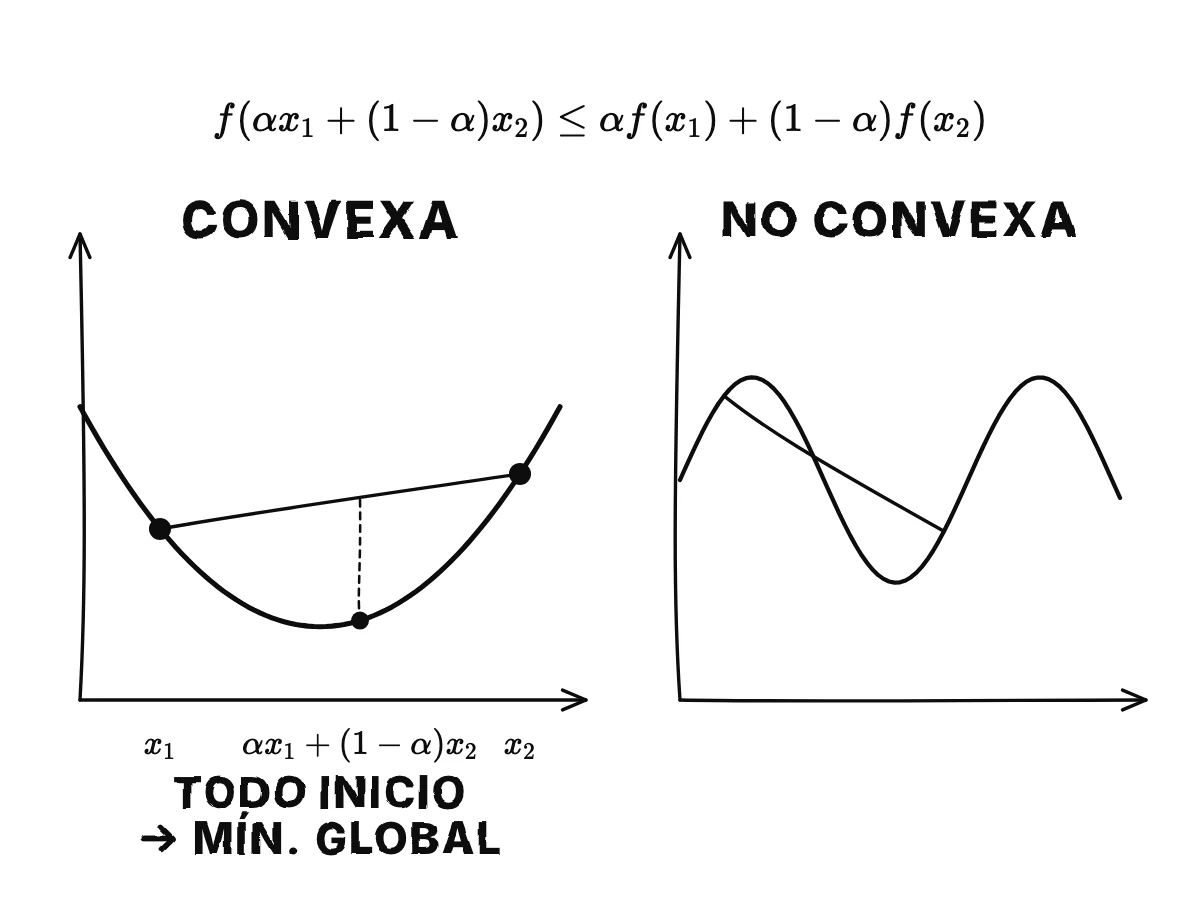
Un cuenco convexo con una cuerda recta entre dos puntos por encima de él; la curva se mantiene por debajo de la cuerda. Al lado, una curva ondulada que una cuerda atraviesa.
Convergencia del descenso de gradiente

Convexa: bajo toda cuerda

Podemos generalizar esta idea con el concepto de convexidad de una función. Hay muchas definiciones posibles de convexidad; elegimos la de abajo por simplicidad de exposición.

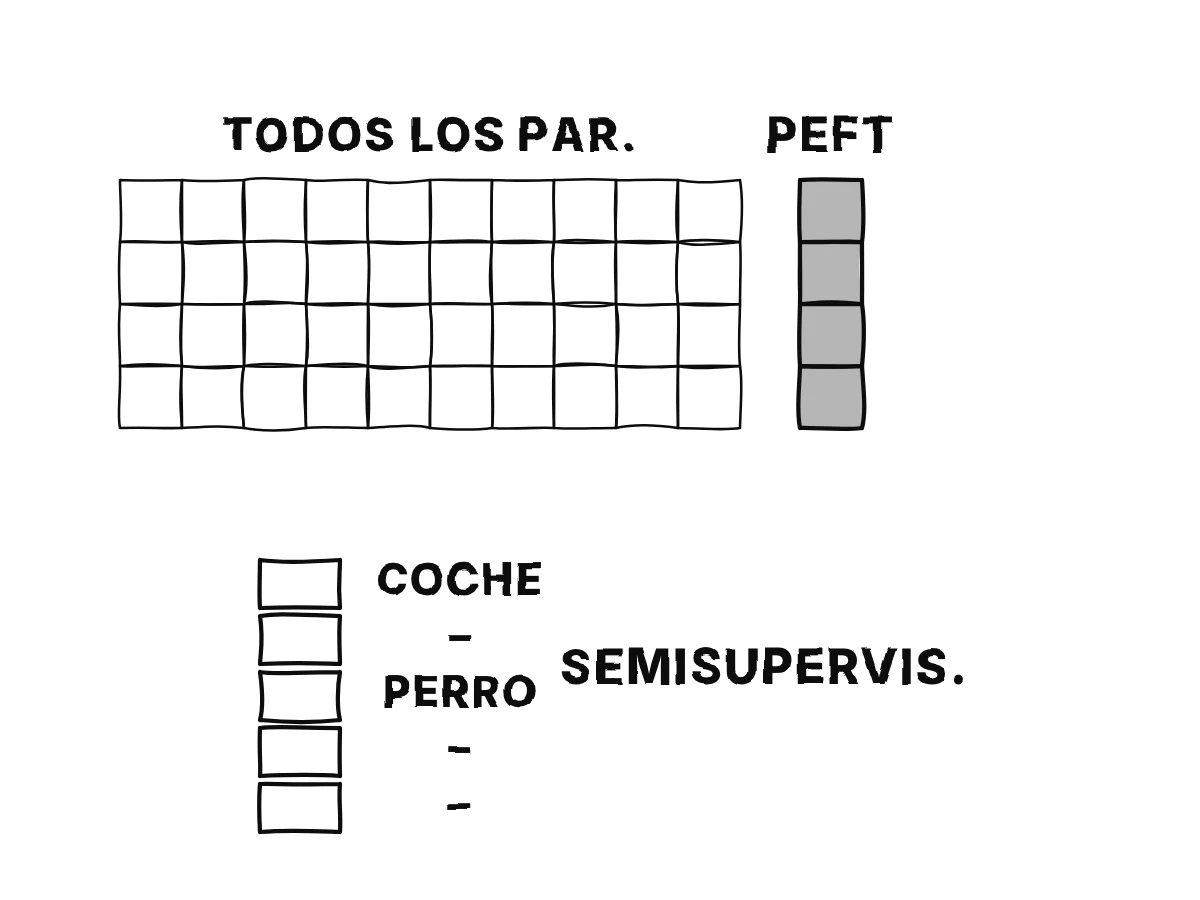
Una gran cuadrícula de celdas grises para los parámetros de un modelo con solo una fina franja de celdas adicionales resaltada; debajo, un conjunto de datos donde solo algunas filas tienen etiquetas.
Variantes del aprendizaje supervisado

Ajustar pocos parámetros

El ajuste fino resulta especialmente fácil gracias a la presencia de grandes repositorios de código abierto en línea.

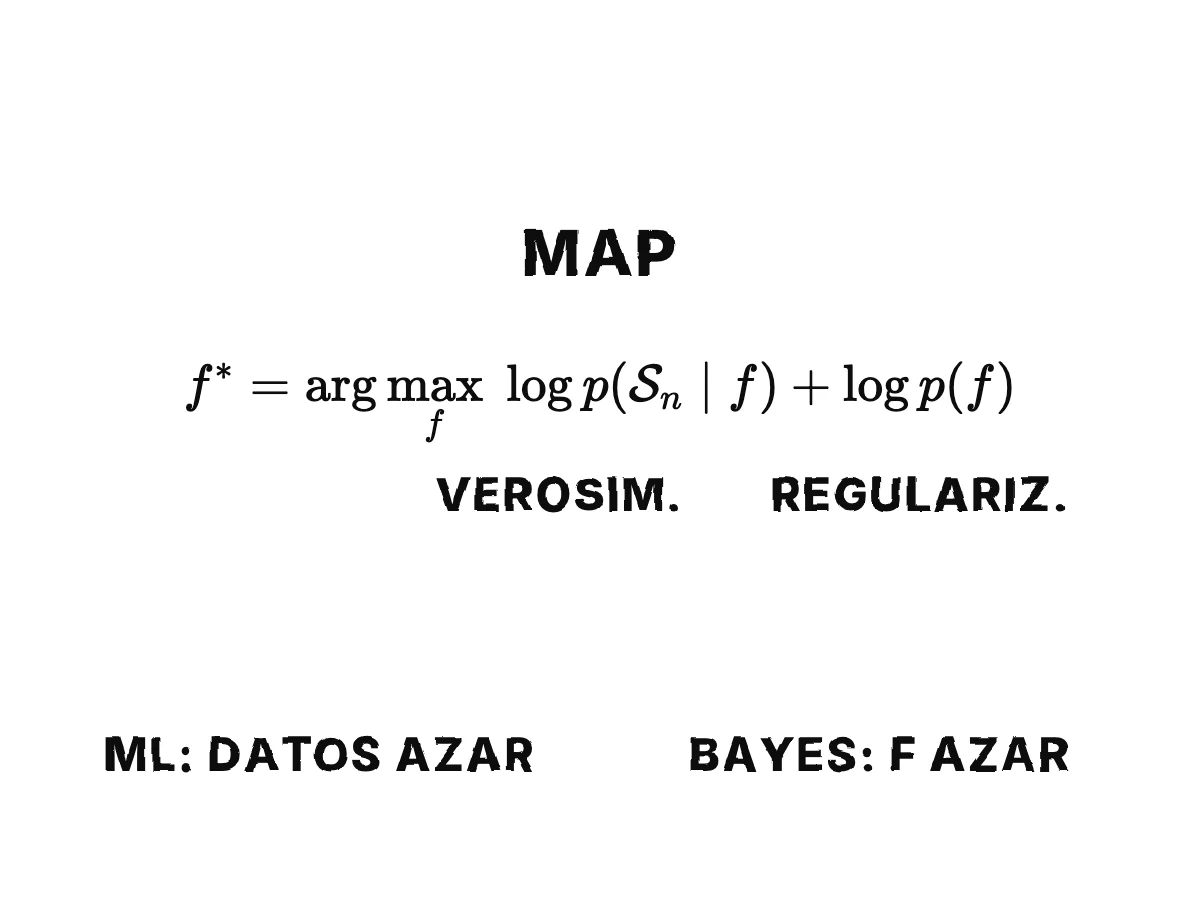
La fórmula MAP dividida en un término de verosimilitud y un término regularizador; con una prior plana el regularizador se vuelve una constante y solo queda la máxima verosimilitud.
Máxima verosimilitud y aprendizaje bayesiano

MAP: verosimilitud más regularizador

La belleza general de este planteamiento se ve empañada por el hecho de que la posterior es en general imposible de calcular en forma cerrada, salvo para elecciones muy concretas de prior y verosimilitud.

How it was made

Examples for: a curious adult with school maths who uses AI apps every day; add one modern instance per idea, such as how a chat assistant or a phone's photo app is trained

The source

The lectures retell the English text of arXiv 2404.17625 (version 3, 2025) by Simone Scardapane, published under an open licence that allows retelling and translation. The retelling, the drawings and the voice are made by AI and checked against the book by a second model. How AI is used.

The lectures adapt the original and are released under the same licence, free to share and adapt with credit to the author and a link to this page: CC BY-SA 4.0

Your own hard book, the same way

Upload a textbook or any difficult book. The first five minutes are free.

Upload a book