Library · CC BY-SA 4.0

Alice's Adventures in aDifferentiable Wonderland

Alice's Adventures in a Differentiable Wonderland, Volume I: A Tour of the Land

Cover illustration of the book

Choose your version

The same text, told at every level, in every language and look shown here. Pick, then listen or download.

Listen and watch

The same player the product gives for your own book: the voice, the drawings as they are drawn, the text.

A modern textbook on how neural networks really work, from tensors and gradients to transformers. Chapter 6 shows how a program finds its own gradients: automatic differentiation, the reverse walk behind every trained model.

This is a sample: 1 of 13 chapters.

From the lectures

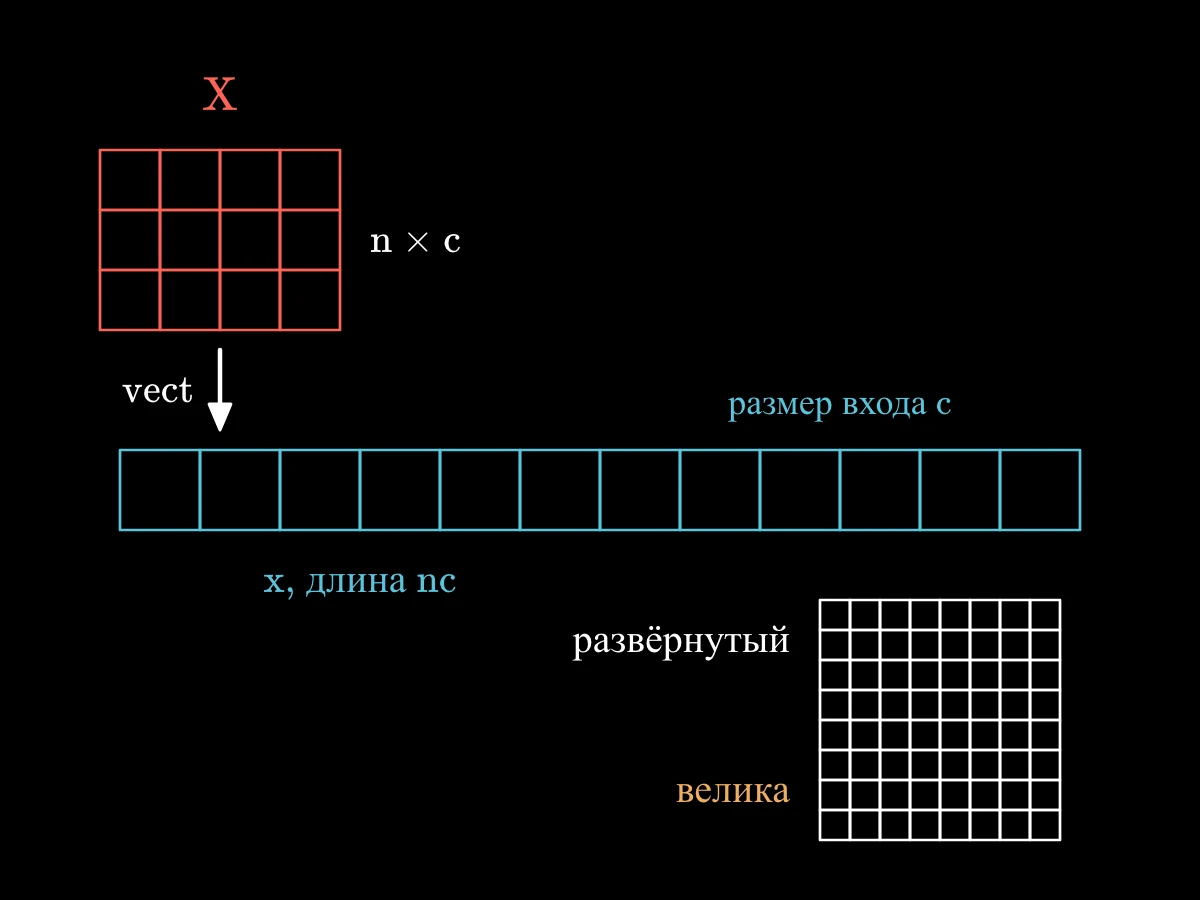
Слева небольшая таблица X из n строк и c столбцов; стрелка превращает её в одну длинную полосу клеток; справа большая квадратная сетка с подписью «развёрнутый якобиан», гораздо больше таблицы, и предупреждающая надпись «не хранить».
Автоматическое дифференцирование

Как батч разворачивается в вектор

О наших обозначениях и якобианах высших порядков. Для удобства чтения мы рассматриваем только векторные величины, так как тогда все получающиеся градиенты — матрицы. На практике у существующих примитивов входы, веса или выходы могут иметь более высокий ранг.
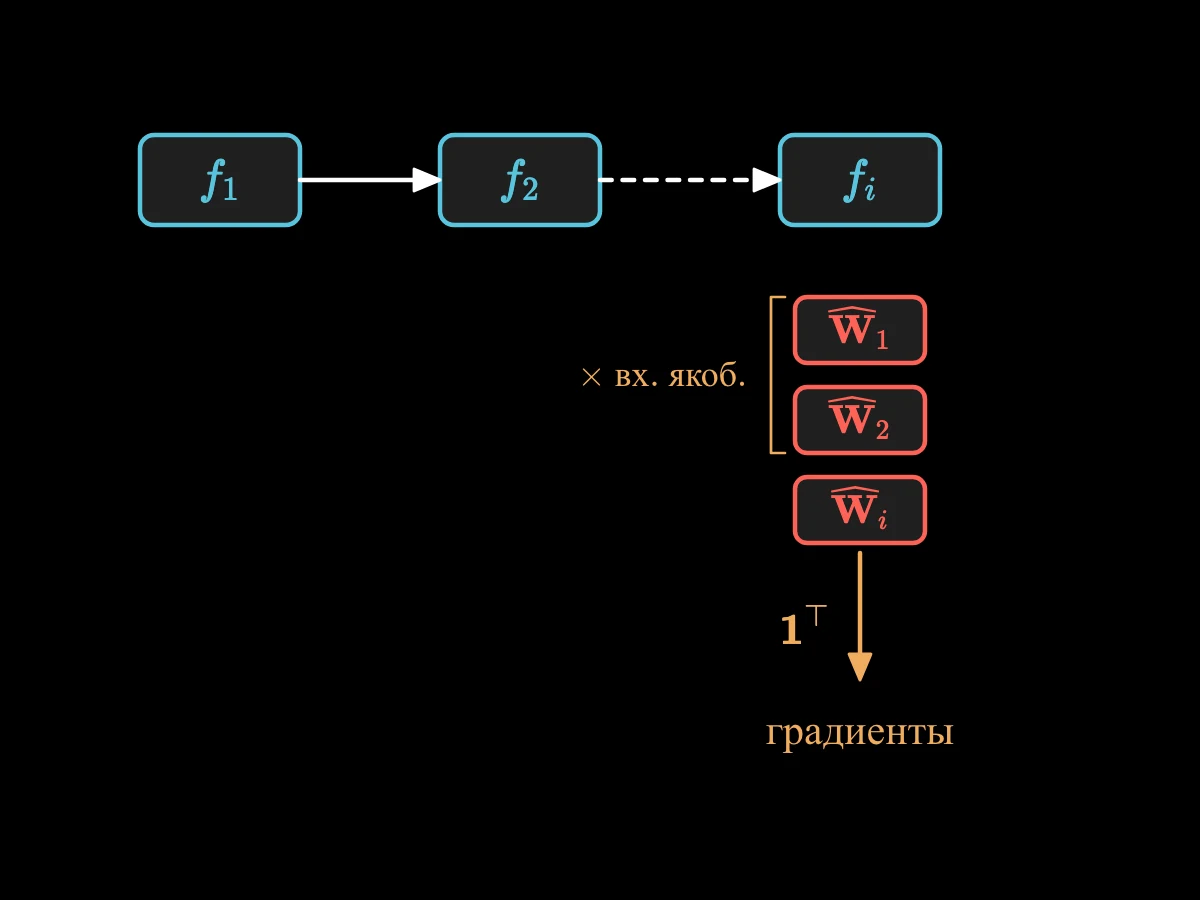
Три блока примитивов в ряд; под первым появляется карточка касательной W с крышкой 1; у второго блока W с крышкой 1 умножается на входной якобиан, и рядом появляется новая W с крышкой 2; у i-го блока все прежние касательные обновляются вместе и добавляется новая; в конце строка единиц превращает каждую касательную в градиент.
Дифференцирование в прямом режиме

Прямой режим несёт касательные

Возьмём первую инструкцию нашей программы, 𝐡₁ = f₁(𝐱, 𝐰₁). Поскольку до сих пор ничего не сохранено, мы задаём касательную матрицу для 𝐰₁ равной её якобиану по весам: Ŵ₁ = ∂_𝐰₁ 𝐡₁. Теперь переходим ко второй инструкции, 𝐡₂ = f₂(𝐡₁, 𝐰₂).

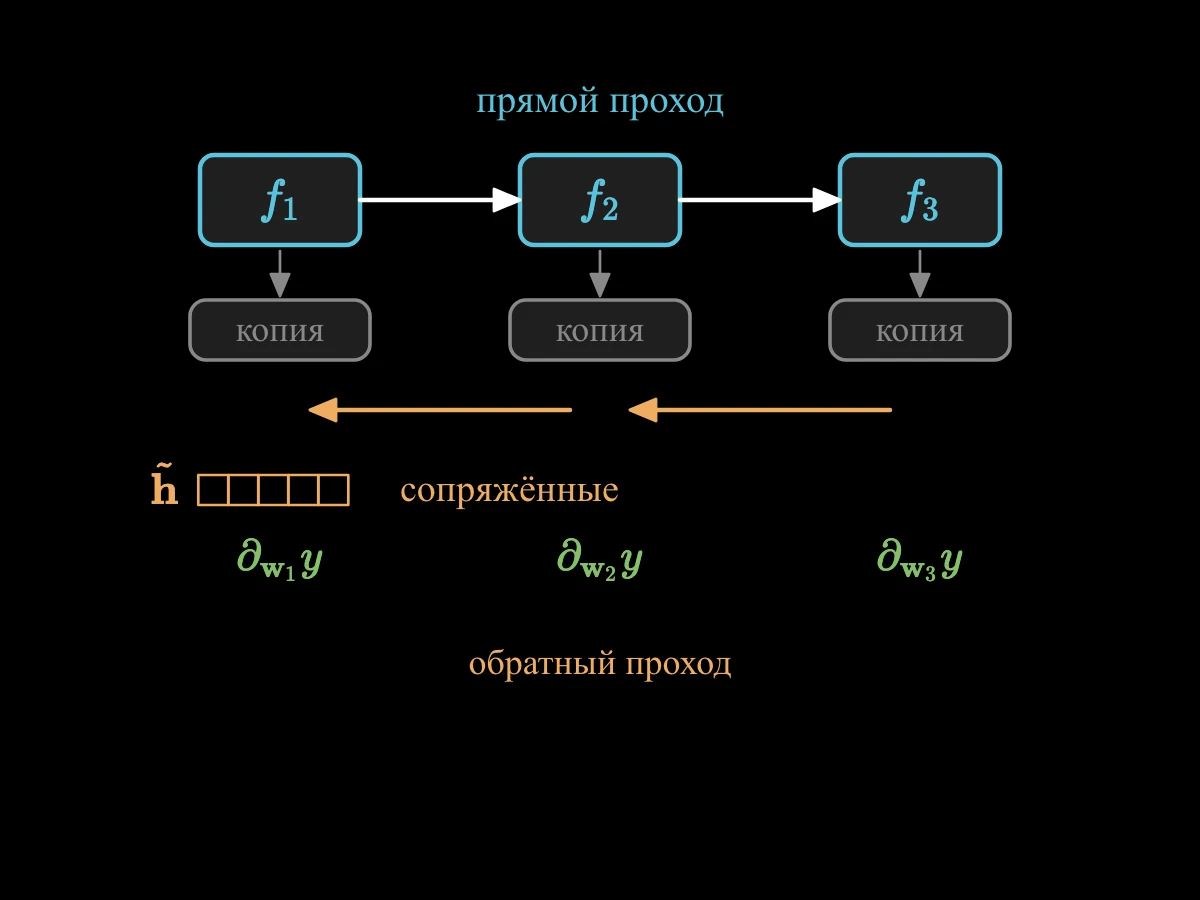
Верхний ряд: три блока f1, f2, f3 работают слева направо, и каждый откладывает свой выход в сохранённую записку внизу; нижний ряд: красная стрелка идёт назад справа налево, неся сопряжённую переменную h с тильдой, и у каждого блока выдаёт зелёный градиент для его весов.
Дифференцирование в обратном режиме

Прямой проход, затем обратный

Соединив эти наблюдения, получаем второй подход к автоматическому дифференцированию, который мы называем автоматическим дифференцированием в обратном режиме, или R-AD; он описан ниже.

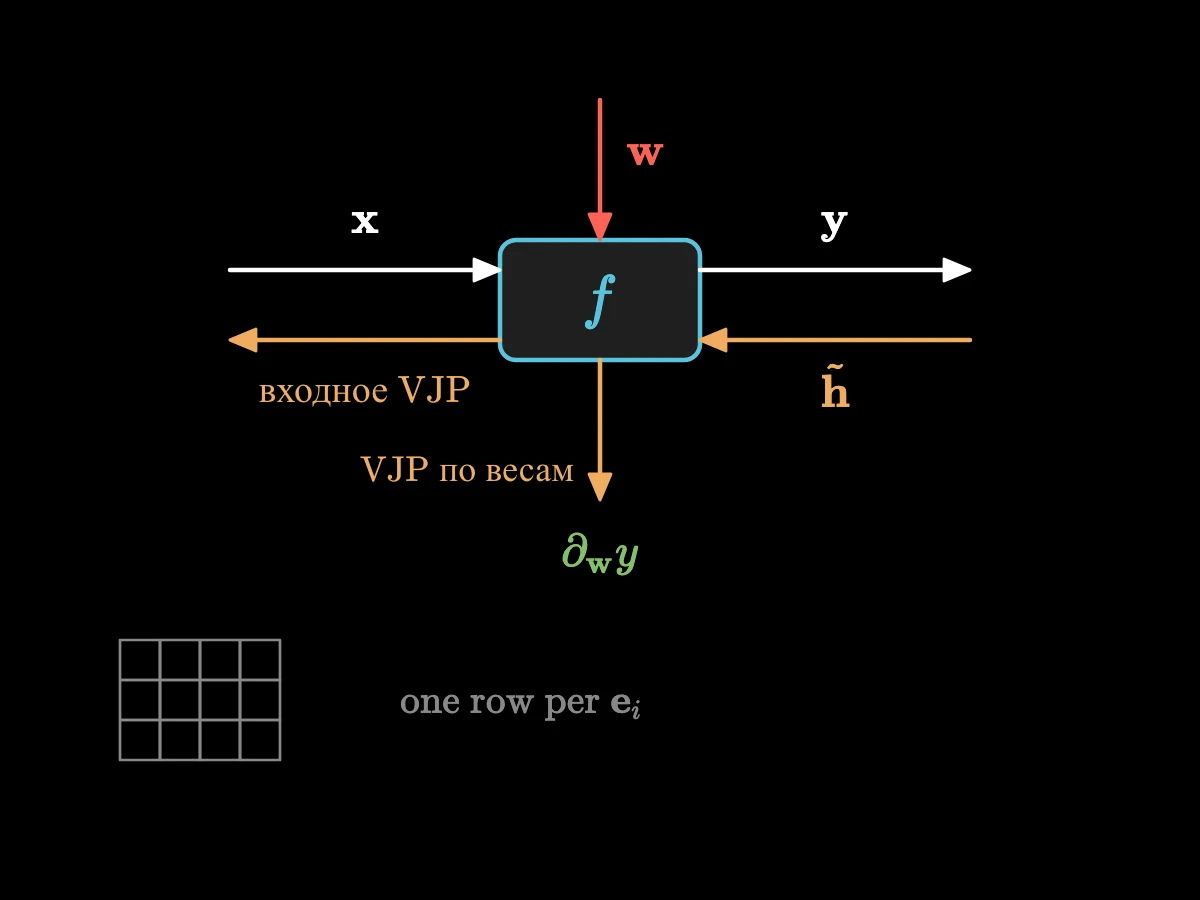
Блок f: x входит слева, y выходит справа; на обратном пути сопряжённая переменная входит справа, и блок возвращает две вещи — входное VJP, идущее влево, и VJP по весам, идущее вниз.
Произведения вектора на якобиан

Примитив с двумя VJP

Значит, целую систему автоматического дифференцирования можно реализовать, сначала выбрав набор примитивных операций, а затем снабдив их соответствующими VJP, ни разу не материализуя якобианы в памяти.

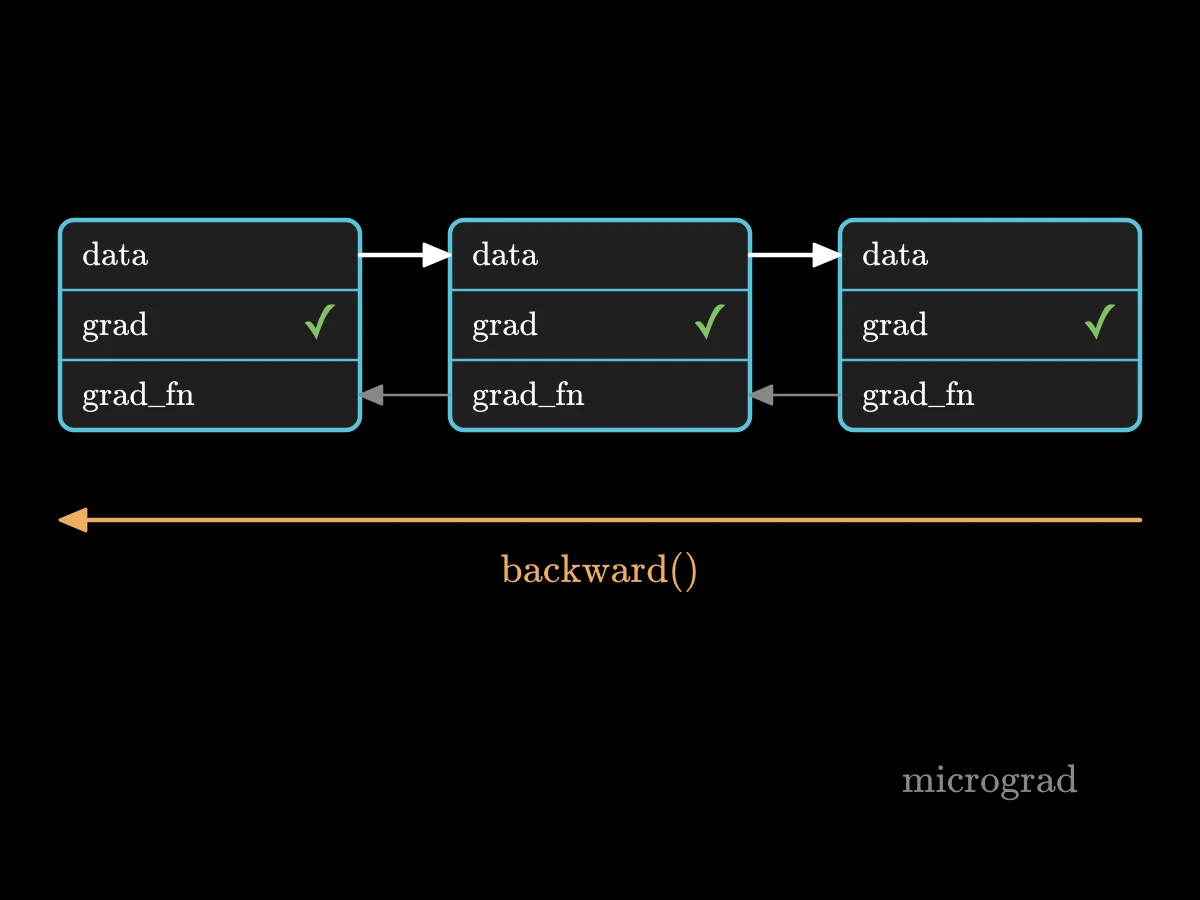
Три карточки тензоров в ряд, на каждой три поля: data, grad (пусто) и grad_fn, указывающее на карточку, которая её создала; красная стрелка с подписью backward идёт от последней карточки к первой и по пути заполняет поля grad.
Реализация системы обратного режима

Тензоры, которые помнят своё происхождение

Как мы уже говорили, на практике наши модели реализованы как композиции объектов, параметры которых инкапсулированы в виде свойств. Одна возможность — «очистить» объект, превратив его в чистую функцию.

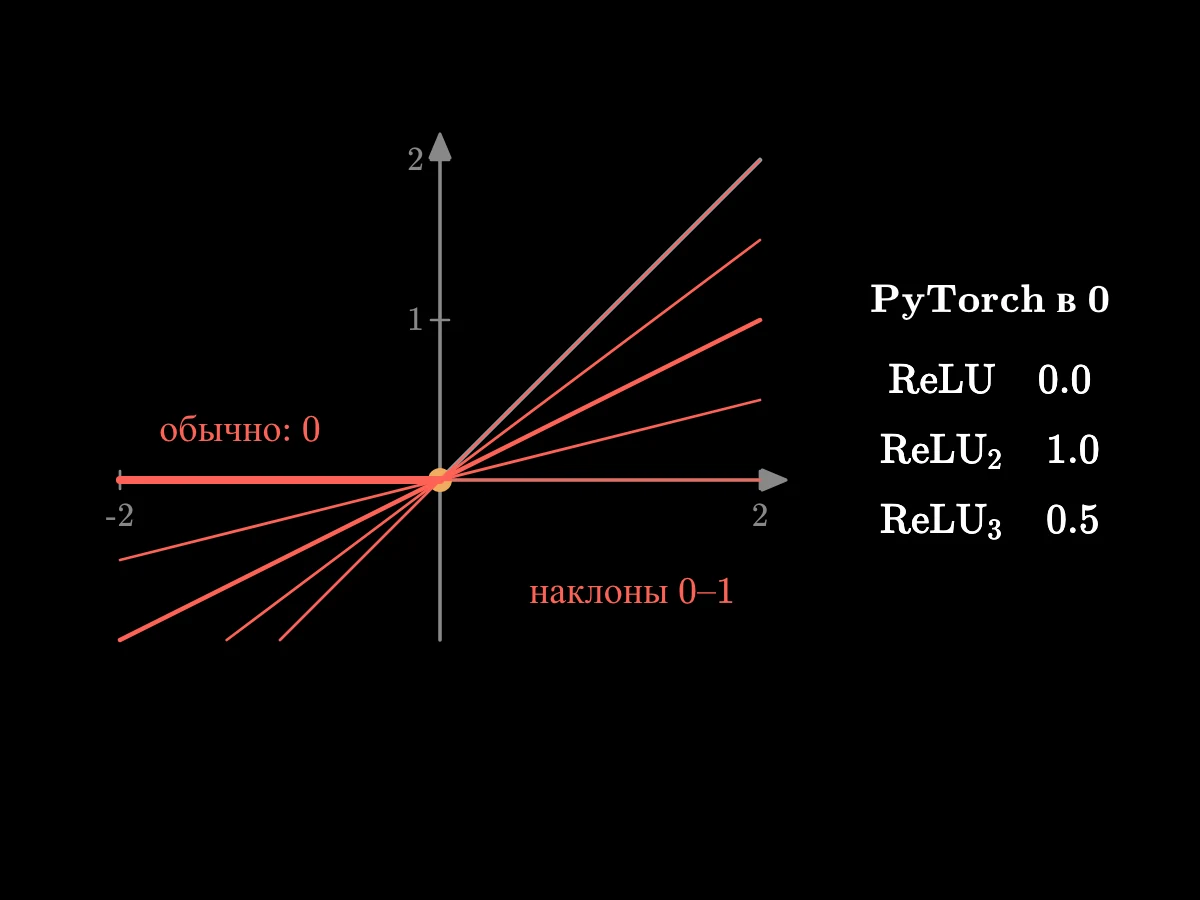
График ReLU с углом в нуле; через угол проходят несколько прямых с наклонами от 0 до 1, и все они остаются ниже графика; небольшая таблица показывает, что PyTorch возвращает 0, 1 и 0,5 для трёх версий одной и той же функции.
Выбор функции активации

Много наклонов в углу

Субдифференцируемость и автоматическое дифференцирование. Есть одна мелочь, которую мы до сих пор обходили: ReLU недифференцируема в 0, из-за чего вся сеть оказывается негладкой. Что происходит в этом случае?

How it was made

Examples for: a curious adult with school maths who uses AI apps every day; add one modern instance per idea, such as how a chat assistant or a phone's photo app is trained

The source

The lectures retell the English text of arXiv 2404.17625 (version 3, 2025) by Simone Scardapane, published under an open licence that allows retelling and translation. The retelling, the drawings and the voice are made by AI and checked against the book by a second model. How AI is used.

The lectures adapt the original and are released under the same licence, free to share and adapt with credit to the author and a link to this page: CC BY-SA 4.0

Your own hard book, the same way

Upload a textbook or any difficult book. The first five minutes are free.

Upload a book