Библиотека · CC BY-SA 4.0

Приключения Алисы в Странедифференцируемых чудес

Alice's Adventures in a Differentiable Wonderland, Volume I: A Tour of the Land

Иллюстрация к книге

Выберите версию

Один и тот же текст на каждом уровне, на всех языках и во всех оформлениях, что здесь есть. Выберите, потом слушайте или скачивайте.

Слушать и смотреть

Тот же плеер, который продукт даёт для вашей книги: голос, рисунки по мере того, как они рисуются, текст.

Современный учебник о том, как на самом деле устроены нейросети: от тензоров и градиентов до трансформеров. Глава 6 показывает, как программа сама находит свои градиенты: автоматическое дифференцирование, обратный проход, на котором обучается любая модель.

Это пробная часть: 1 из 13 (главы).

Из лекций

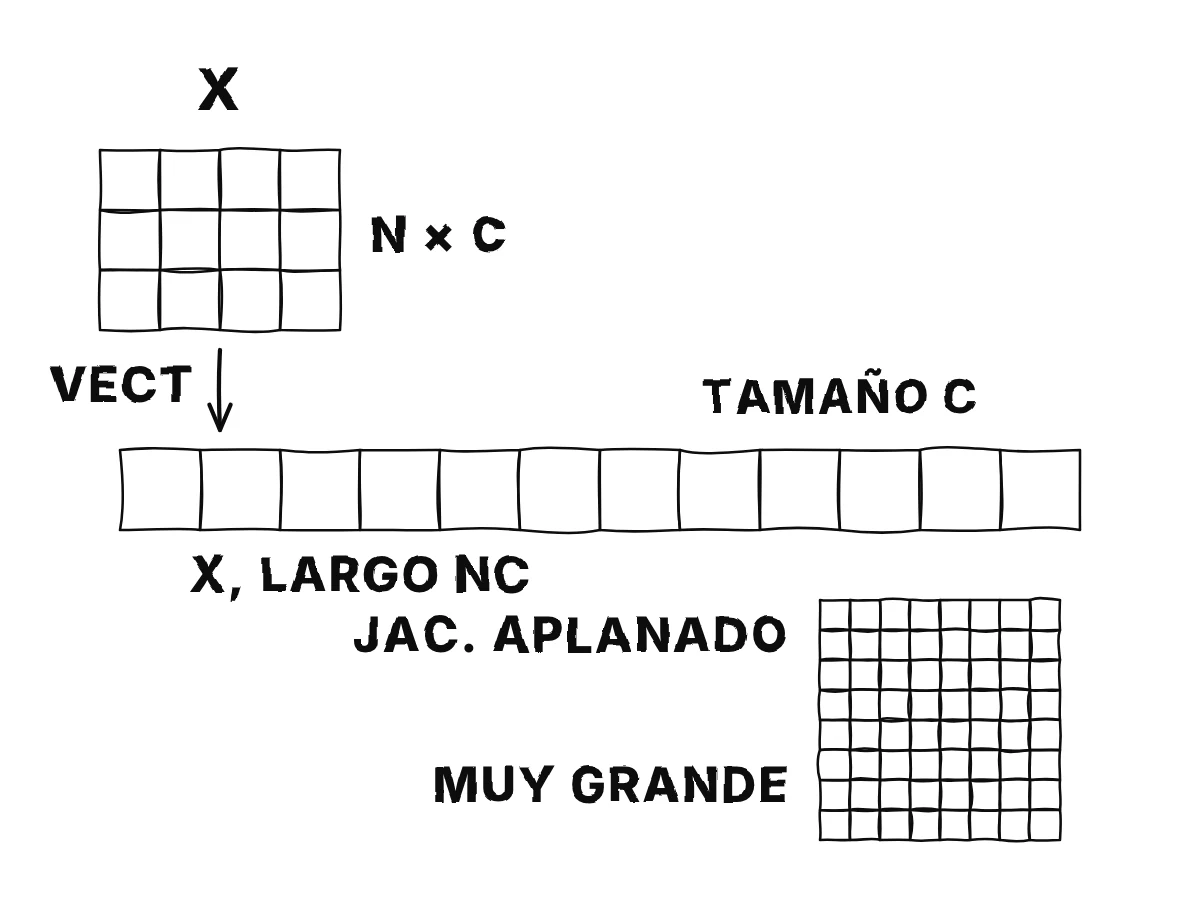
A la izquierda, una pequeña tabla X de n filas y c columnas; una flecha la convierte en una sola tira larga de celdas; a la derecha, una gran cuadrícula cuadrada rotulada jacobiano aplanado, mucho mayor que la tabla, con una advertencia: demasiado grande para guardar.
Diferenciación automática

Aplanar un lote en un vector

Sobre nuestra notación y los jacobianos de orden superior. Por legibilidad solo consideramos magnitudes vectoriales, ya que así todos los gradientes resultantes son matrices. En la práctica, las primitivas existentes pueden tener entradas, pesos o salidas de rango mayor.
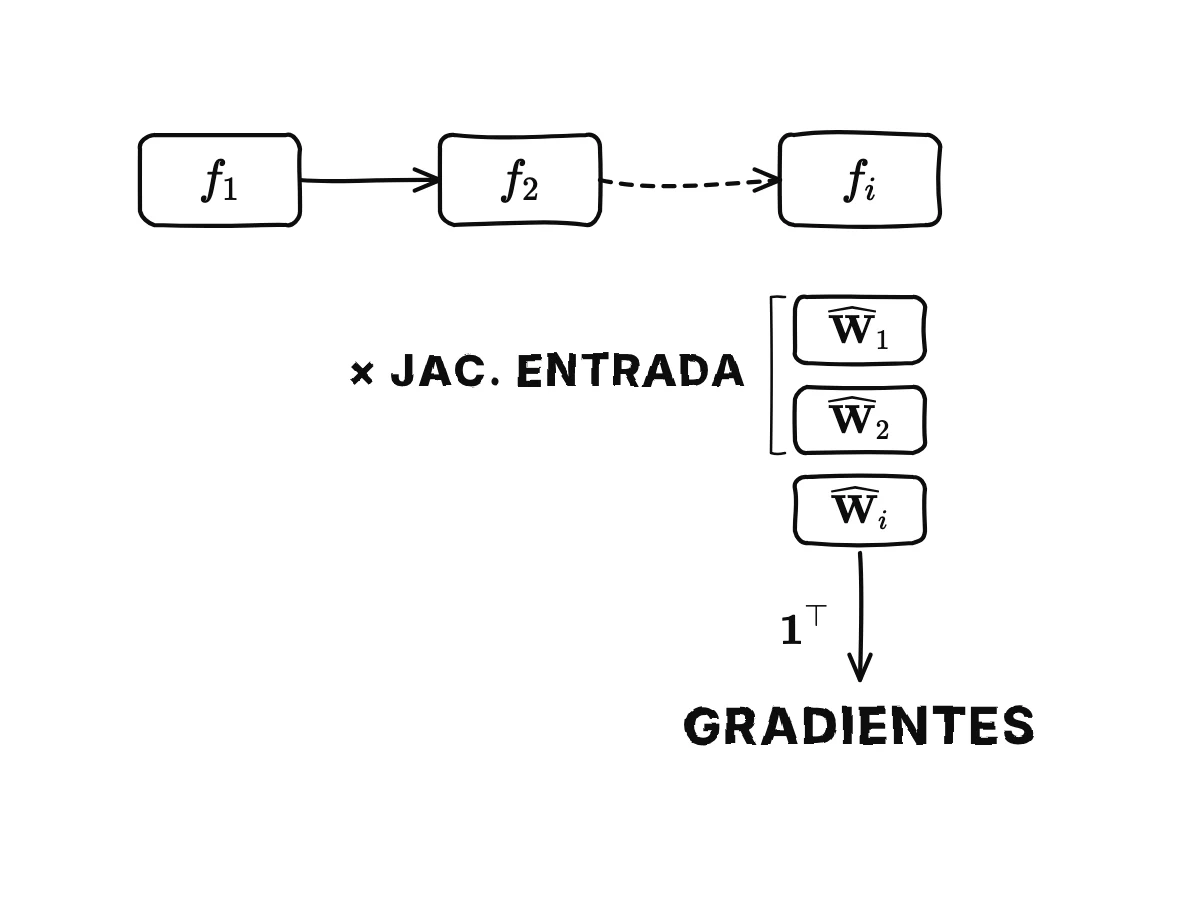
Tres cajas primitivas en fila; bajo la primera aparece una tarjeta tangente W gorro 1; en la segunda caja, W gorro 1 se multiplica por el jacobiano de entrada y aparece a su lado un nuevo W gorro 2; en la i-ésima caja se actualizan juntas todas las tangentes anteriores y se añade una nueva; al final, una fila de unos convierte cada tangente en un gradiente.
Diferenciación en modo directo

El modo directo lleva consigo las tangentes

Considere la primera instrucción de nuestro programa, 𝐡₁ = f₁(𝐱, 𝐰₁). Como hasta ahora no se ha guardado nada, inicializamos la matriz tangente de 𝐰₁ como su jacobiano de los pesos: Ŵ₁ = ∂_𝐰₁ 𝐡₁. Pasamos ahora a la segunda instrucción, 𝐡₂ = f₂(𝐡₁, 𝐰₂).

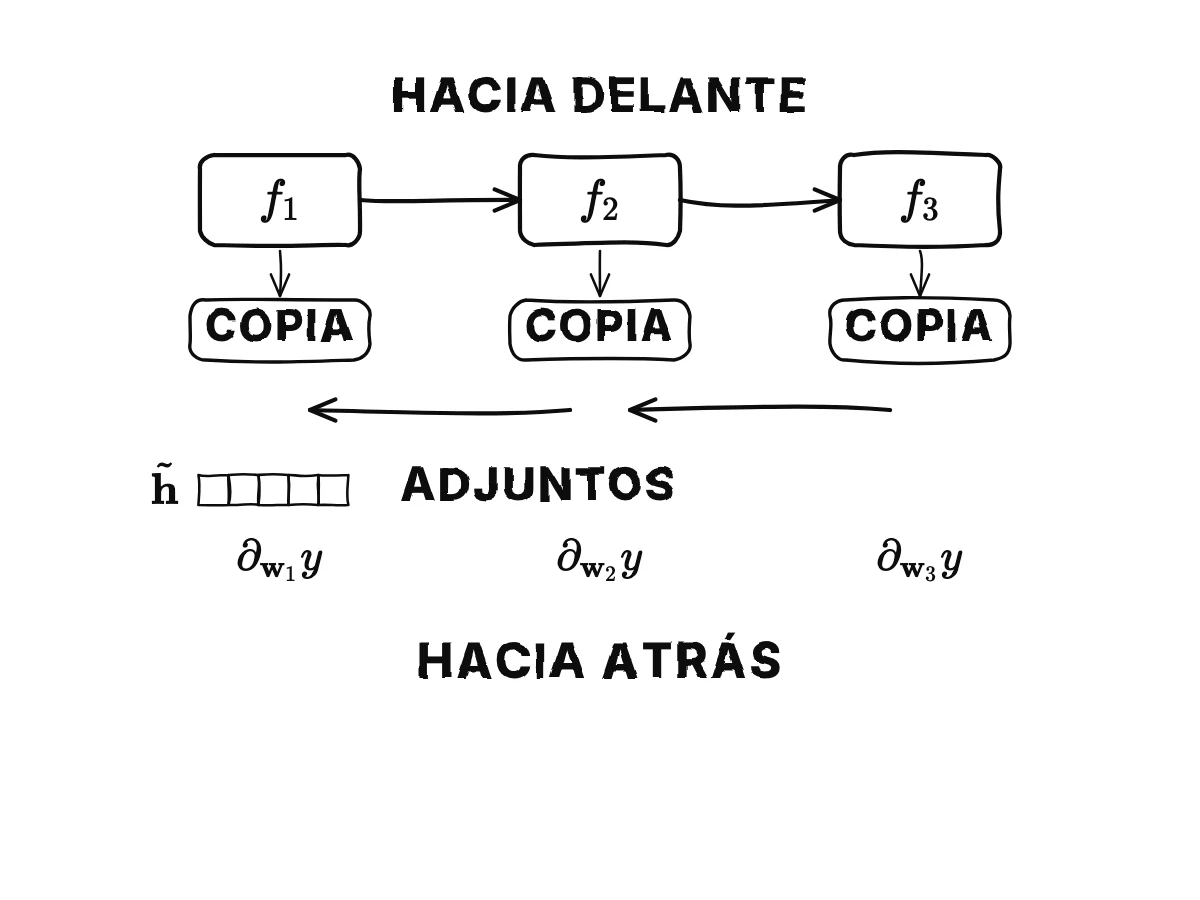
Fila de arriba: tres cajas f1, f2, f3 se ejecutan de izquierda a derecha, y cada una deja su salida en una nota guardada debajo; fila de abajo: una flecha roja vuelve de derecha a izquierda llevando el adjunto h con tilde, y en cada caja entrega un gradiente verde para los pesos de esa caja.
Diferenciación en modo inverso

Pasada hacia delante, luego pasada hacia atrás

Juntando estas observaciones podemos desarrollar un segundo enfoque de la diferenciación automática, que llamamos diferenciación automática en modo inverso, o R-AD, y que se describe a continuación.

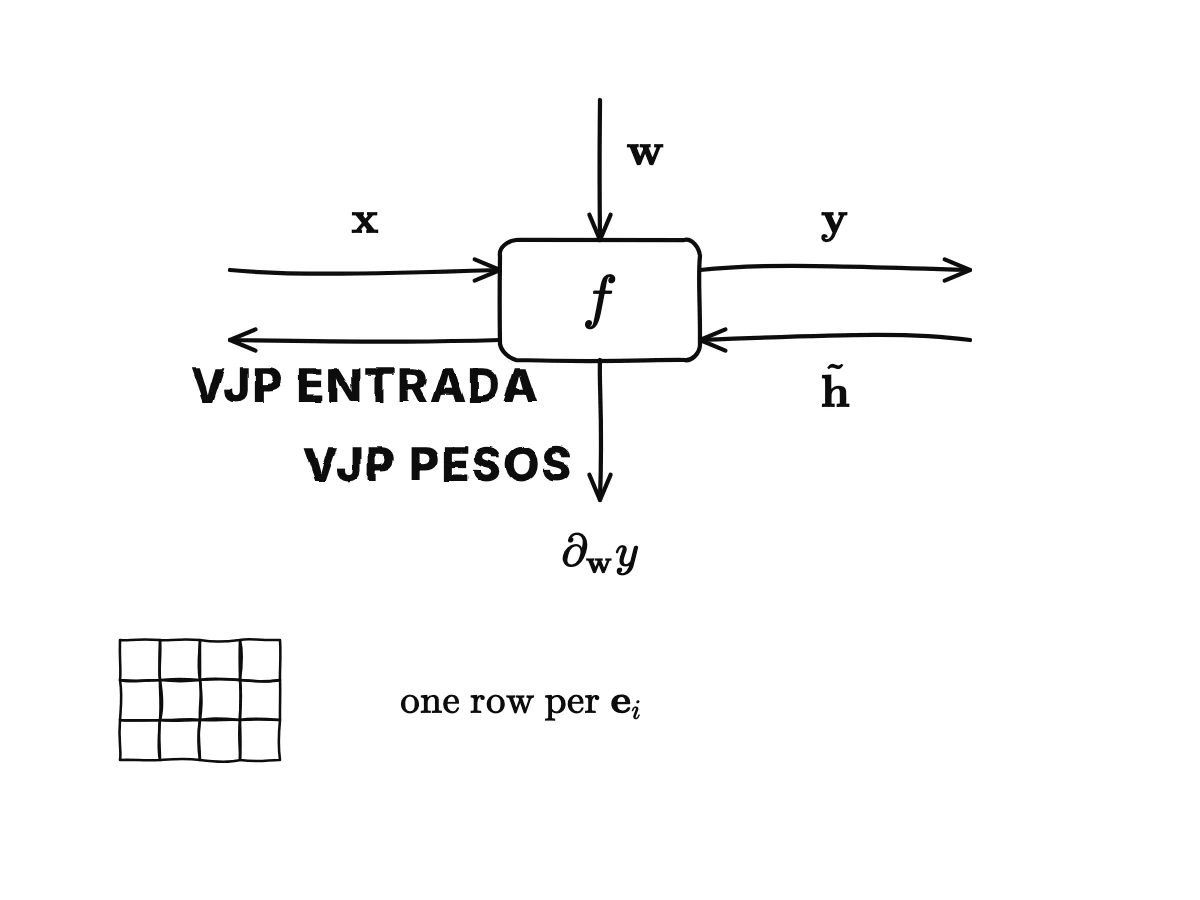
Una caja f con x entrando por la izquierda e y saliendo por la derecha; a la vuelta, el adjunto entra por la derecha y la caja devuelve dos cosas, el VJP de entrada hacia la izquierda y el VJP de los pesos hacia abajo.
Productos vector-jacobiano

Una primitiva con dos VJP

Por tanto, podemos implementar todo un sistema de diferenciación automática eligiendo primero un conjunto de operaciones primitivas y ampliándolas después con los VJP correspondientes, sin tener que materializar los jacobianos en memoria en ningún momento.

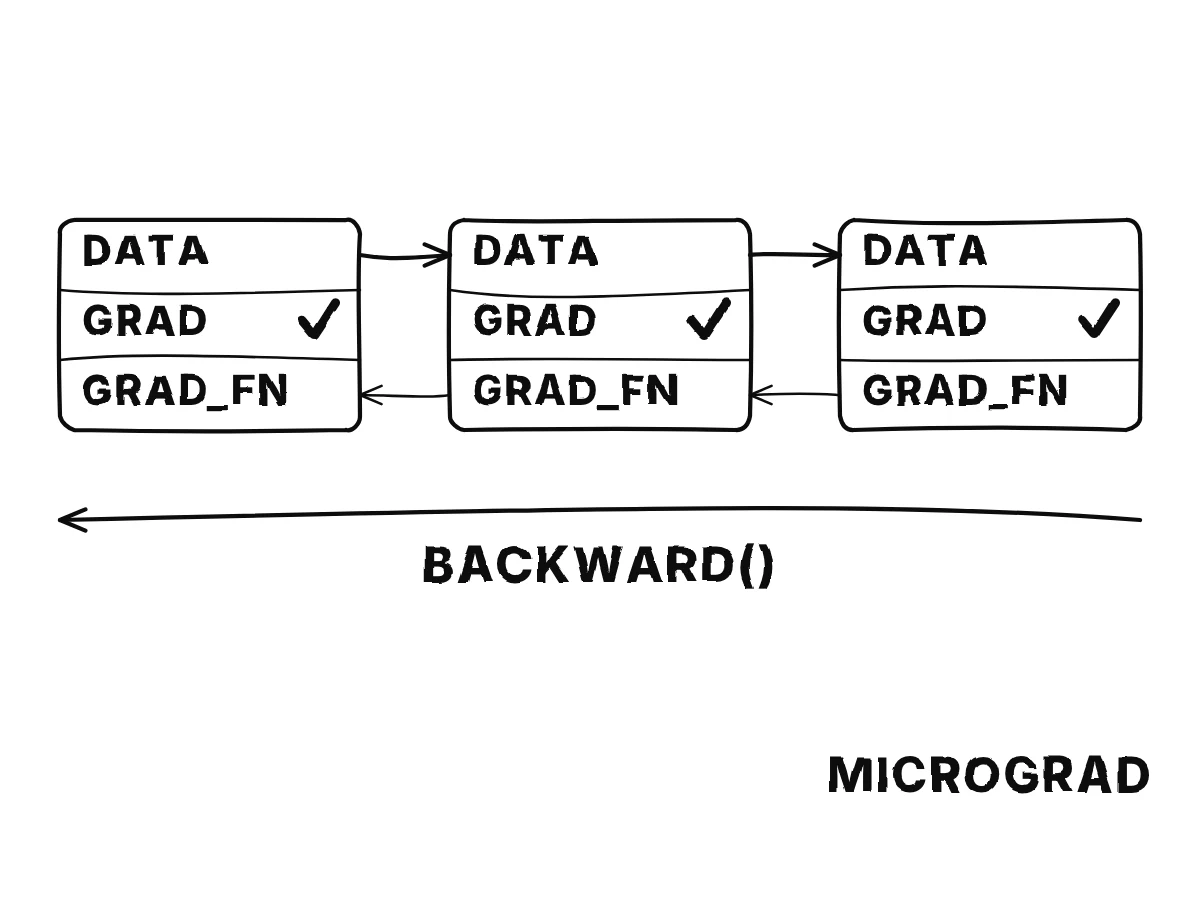
Tres tarjetas de tensor en fila, cada una con tres campos: data, grad (vacío) y grad_fn, que apunta a la tarjeta que la produjo; una flecha roja rotulada backward va de la última tarjeta a la primera y llena los campos grad a su paso.
Implementar un sistema en modo inverso

Tensores que recuerdan su origen

Como ya dijimos, en la práctica nuestros modelos se implementan como composiciones de objetos cuyos parámetros están encapsulados como propiedades. Una posibilidad es «purificar» el objeto, convirtiéndolo en una función pura.

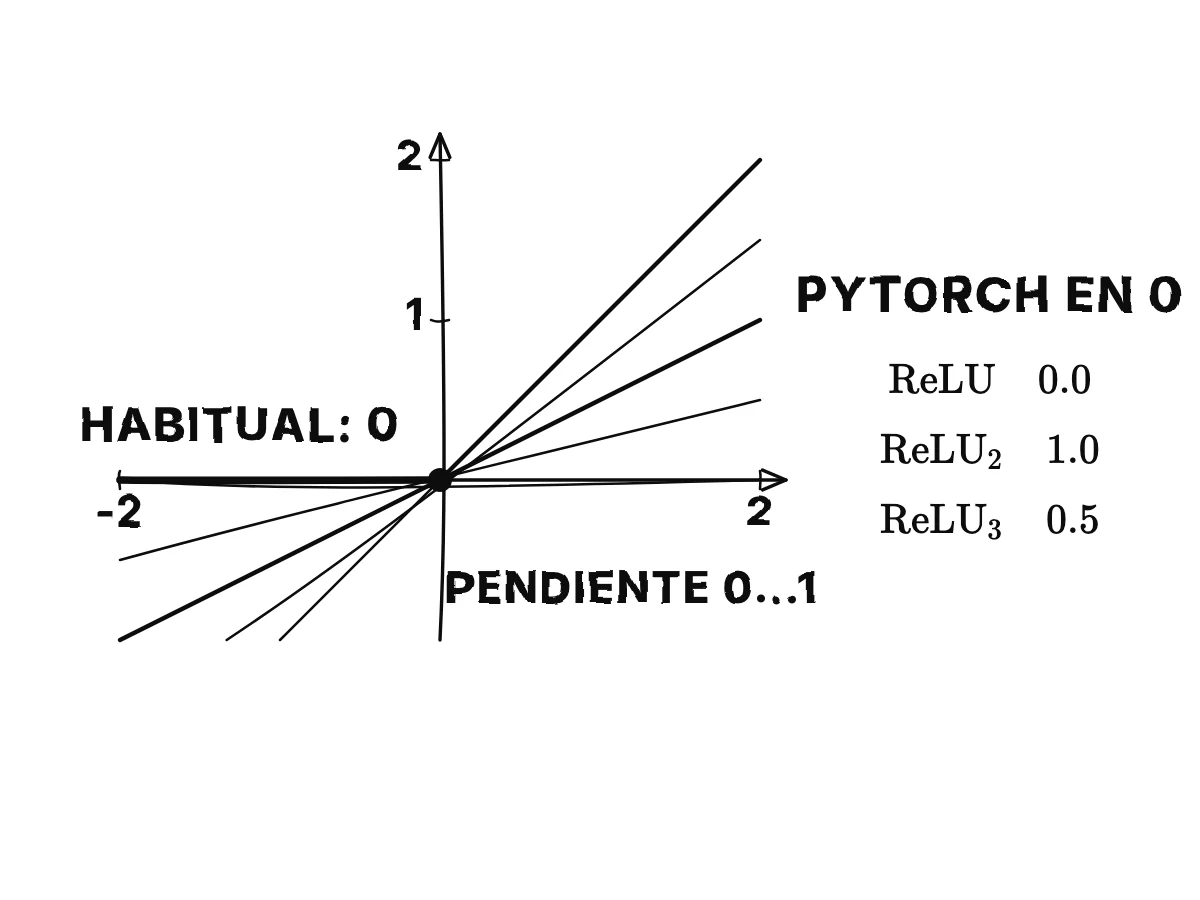
La gráfica de la ReLU con su esquina en cero; varias rectas pasan por la esquina con pendientes entre 0 y 1, todas por debajo de la gráfica; una pequeña tabla muestra que PyTorch devuelve 0, 1 y 0,5 para tres versiones de la misma función.
Elegir una función de activación

Muchas pendientes en la esquina

Subdiferenciabilidad y diferenciación automática. Hay un pequeño detalle que hemos evitado discutir hasta ahora: la ReLU no es diferenciable en 0, lo que hace que la red en su conjunto no sea suave. ¿Qué ocurre en este caso?

Как это сделано

Примеры для: a curious adult with school maths who uses AI apps every day; add one modern instance per idea, such as how a chat assistant or a phone's photo app is trained

Источник

Лекции пересказывают с английского оригинала книгу arXiv 2404.17625 (version 3, 2025), автор — Симоне Скардапане; книга вышла под открытой лицензией, которая разрешает пересказ и перевод. Пересказ, рисунки и голос сделаны ИИ и сверены с книгой второй моделью. Как используется ИИ.

Лекции — переработка оригинала и распространяются под той же лицензией: их можно свободно распространять и перерабатывать с указанием автора и ссылкой на эту страницу: CC BY-SA 4.0

Ваша трудная книга — так же

Загрузите учебник или любую сложную книгу. Первые пять минут бесплатно.

Загрузить книгу