Aprender es buscar
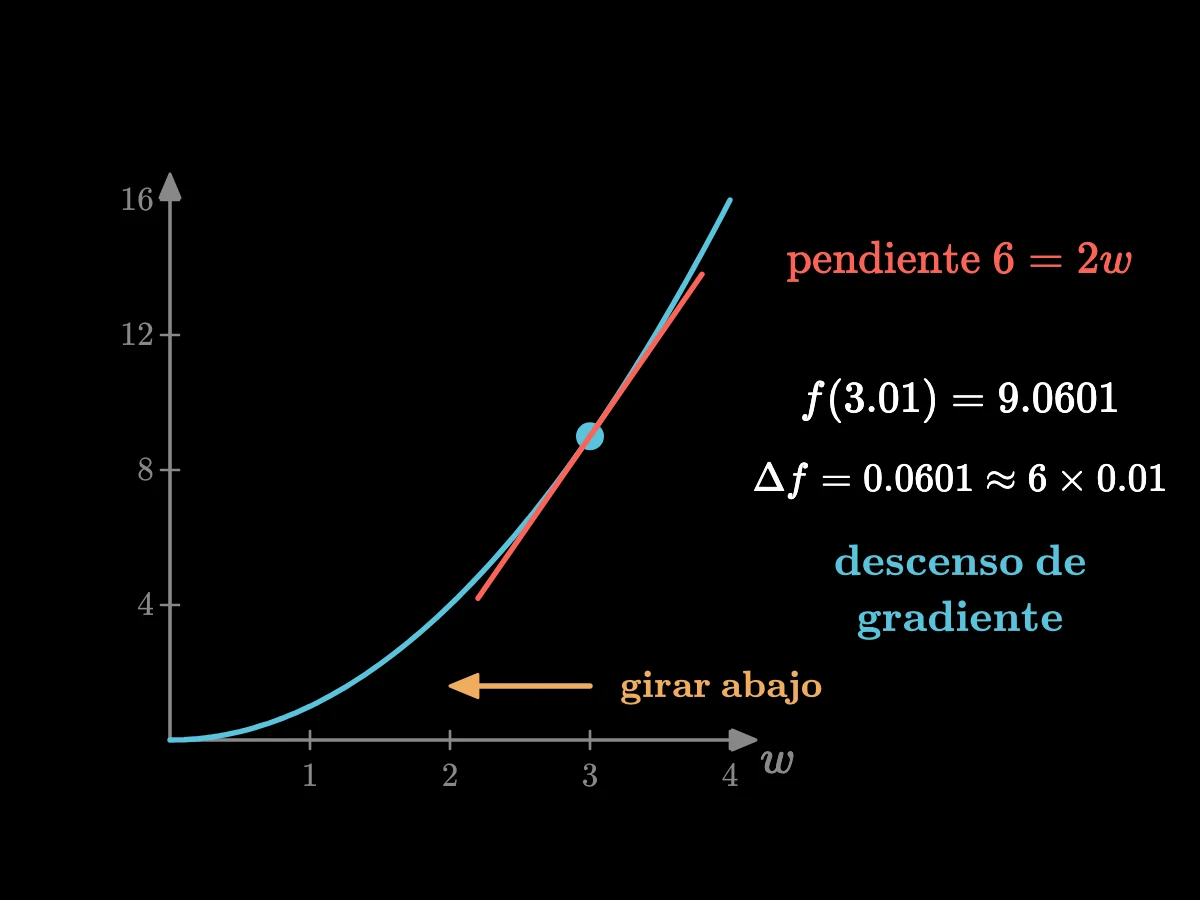
Pendiente de w al cuadrado en tres
Aquí está la idea con una sola rueda y números que podemos comprobar. Suponga que el error de un modelo es f(w) = w², y la rueda está en w = 3, así que el error es nueve.
Alice's Adventures in a Differentiable Wonderland, Volume I: A Tour of the Land
The same text, told at every level, in every language and look shown here. Pick, then listen or download.
The same player the product gives for your own book: the voice, the drawings as they are drawn, the text.
A modern textbook on how neural networks really work, from tensors and gradients to transformers. The first three chapters lay the ground: what the book is about, the linear algebra and calculus a network runs on, gradient descent, and what a dataset and a loss function are.
This is a sample: 3 of 13 chapters.
Aquí está la idea con una sola rueda y números que podemos comprobar. Suponga que el error de un modelo es f(w) = w², y la rueda está en w = 3, así que el error es nueve.
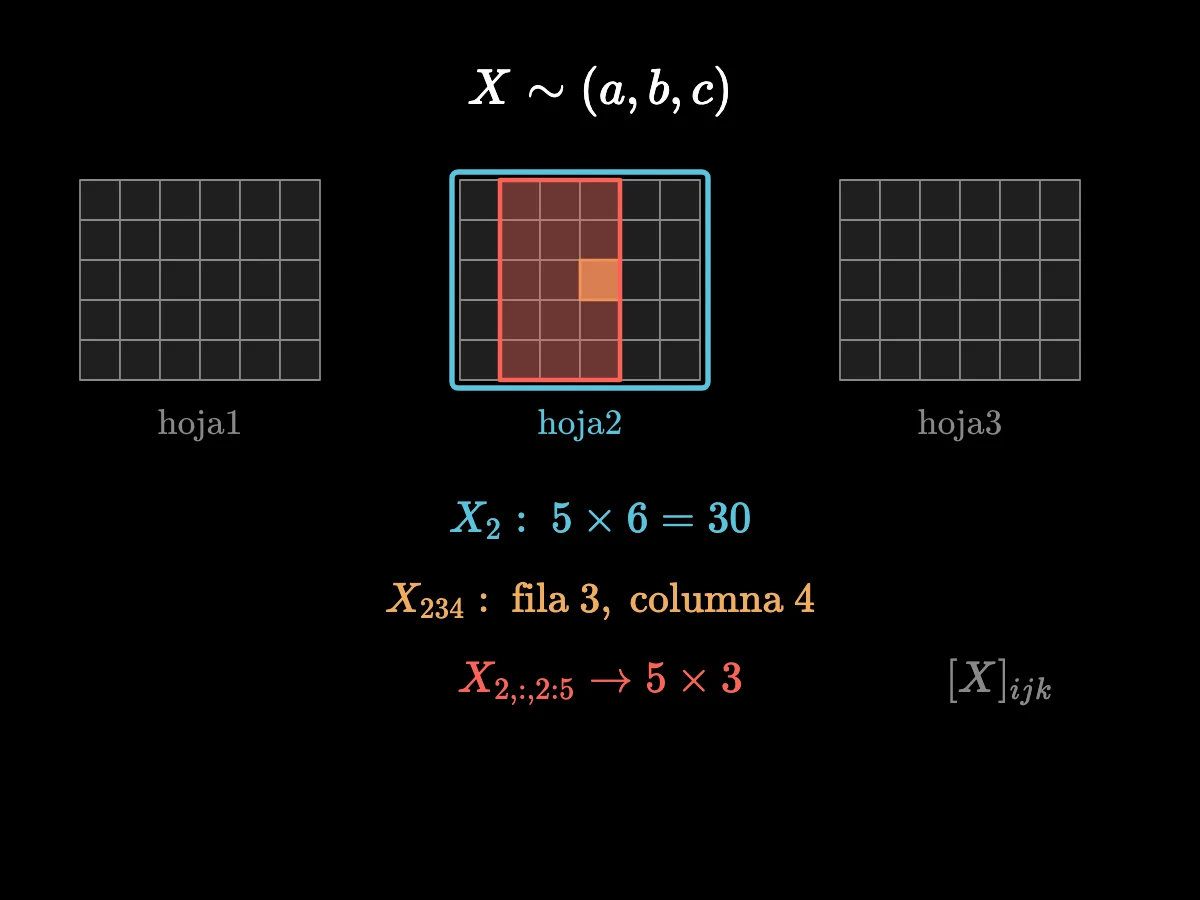
Tome un tensor tridimensional X ∼ (a, b, c). Entonces Xᵢ es una rebanada de forma (b, c): en nuestro lote de fotos, X₂ es la segunda foto entera, una rejilla de 5 por 6 con 30 números.
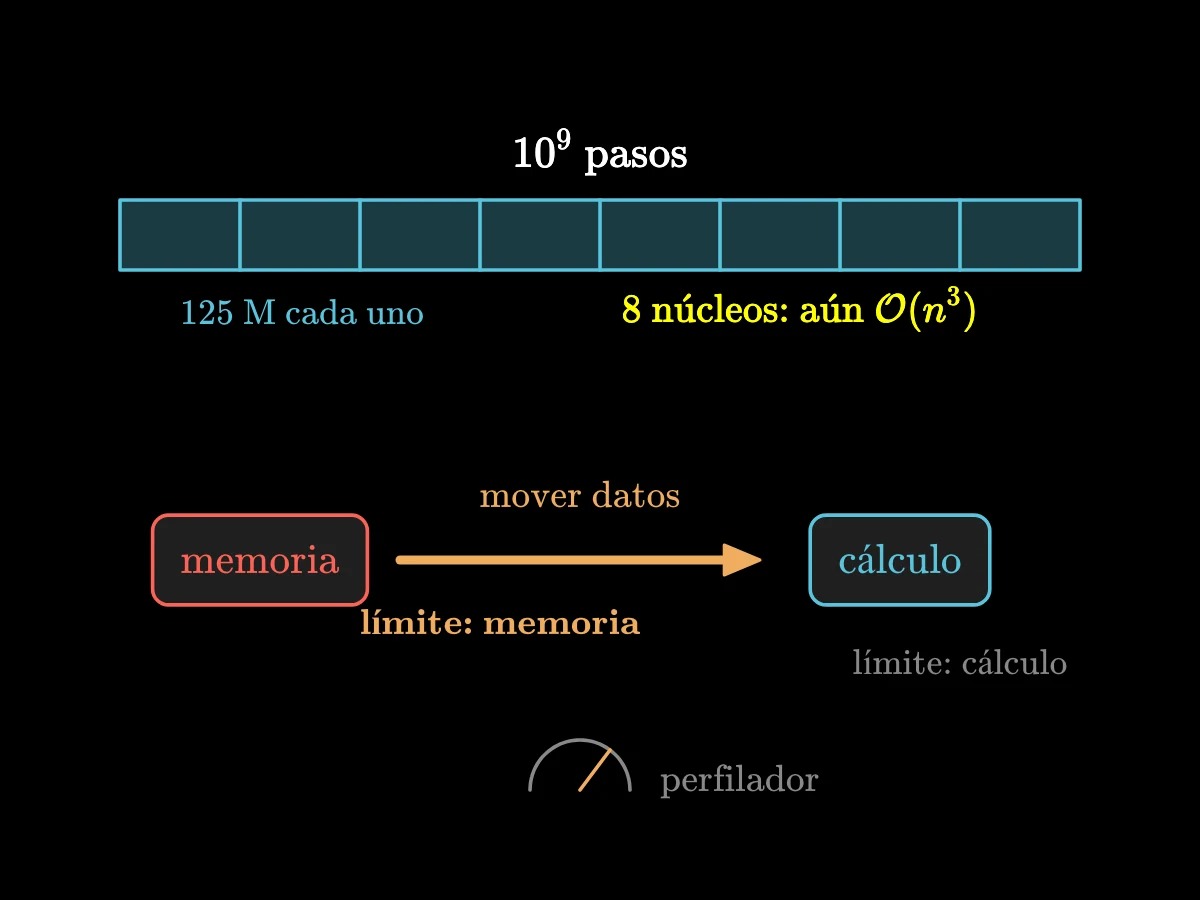
Dos límites más del pensamiento asintótico. Primero, tener k procesadores no cambia en absoluto la O grande: como mucho divide el tiempo por k, un factor constante; ocho núcleos convierten mil millones de pasos en 125 millones cada uno, todavía cúbico en n.
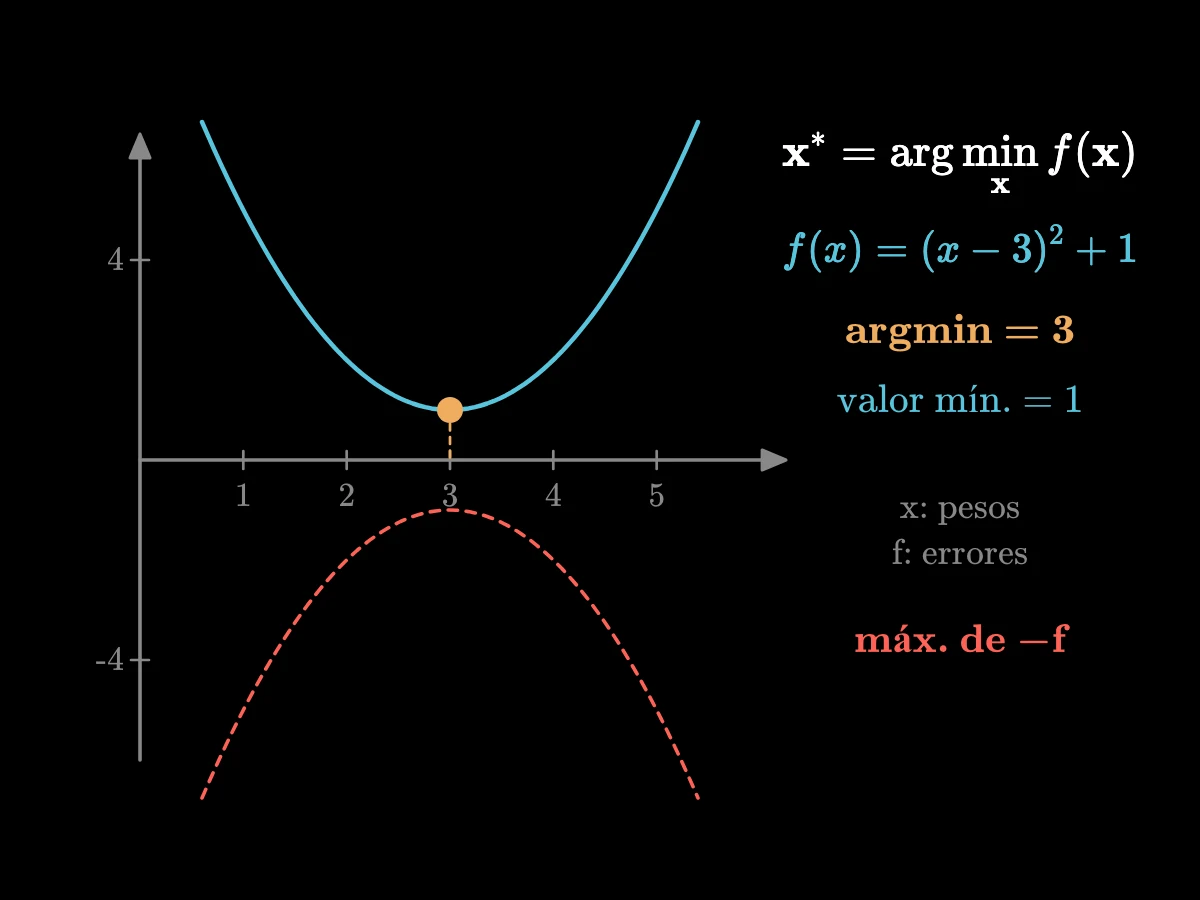
Ahora la razón por la que los gradientes merecen todo esto: la sección 2.3, el descenso de gradiente. La tarea es minimizar una función f(𝐱) con 𝐱 ∼ (d): 𝐱* = argmin f(𝐱). Como argmax, argmin significa «el valor de x que da la f más baja posible».
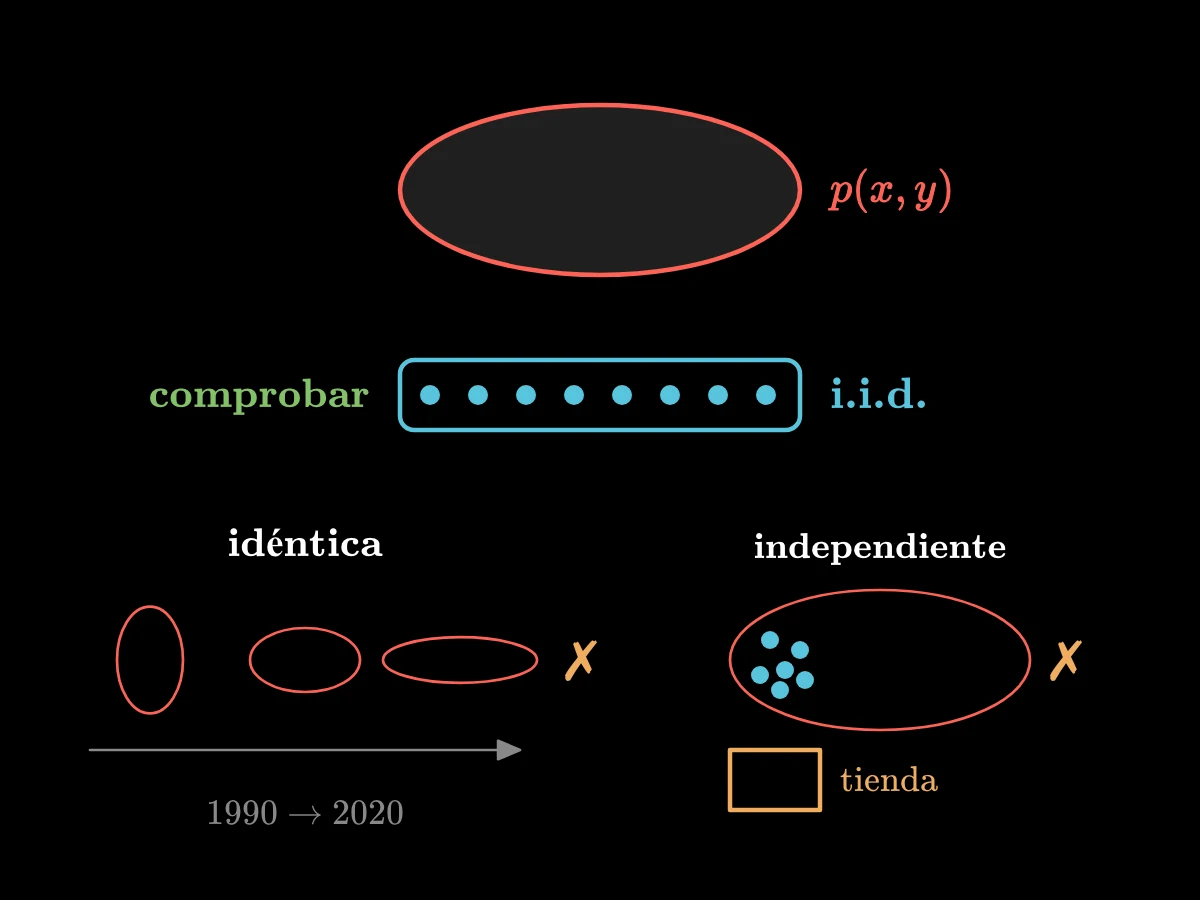
Se añade un supuesto más, y es crucial: cada ejemplo es una extracción independiente e idénticamente distribuida, i.i.d., de alguna distribución de probabilidad p(x, y) desconocida, y de hecho incognoscible. Suena técnico, pero es lo que da sentido a la tarea.
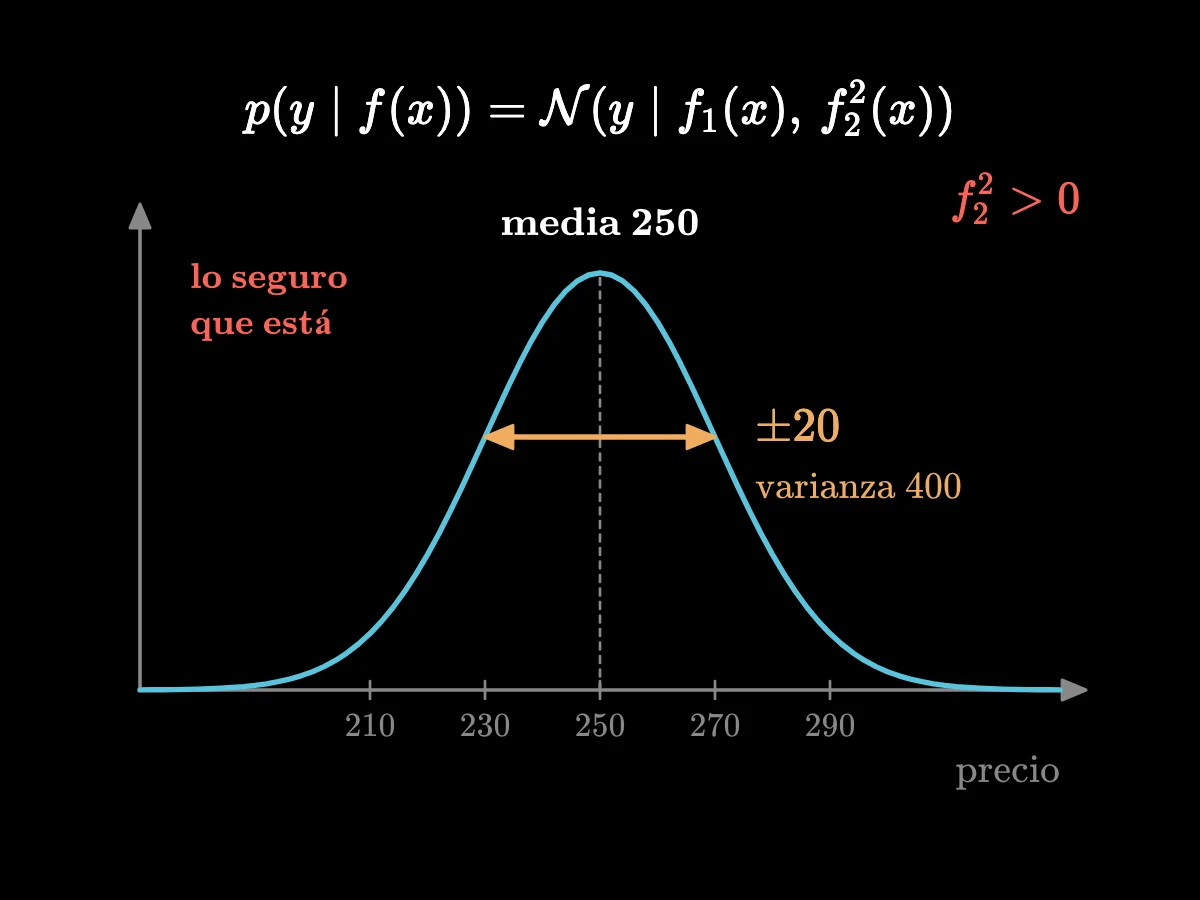
Para la regresión, predecir un número real y ∈ ℝ, el modelo puede producir dos valores, f(x) ∼ (2), la media y la dispersión de una gaussiana, una curva de campana: p(y ∣ f(x)) = 𝒩(y ∣ f₁(x), f₂²(x)). La segunda salida se eleva al cuadrado para que la varianza sea siempre positiva.
Examples for: a curious adult with school maths who uses AI apps every day; add one modern instance per idea, such as how a chat assistant or a phone's photo app is trained
The lectures retell the English text of arXiv 2404.17625 (version 3, 2025) by Simone Scardapane, published under an open licence that allows retelling and translation. The retelling, the drawings and the voice are made by AI and checked against the book by a second model. How AI is used.
The lectures adapt the original and are released under the same licence, free to share and adapt with credit to the author and a link to this page: CC BY-SA 4.0
Upload a textbook or any difficult book. The first five minutes are free.
Upload a book